Refonte
Le carnet de La Refonte
Un grand modèle de langage rédige, un modèle de décision tranche. Le critère qui départage les deux tient en une question : qui lit la sortie, du code ou une personne ?
Refonte
SEO
IA
Choisissez selon la forme de la sortie attendue. Si du code doit lire le résultat (catégorie, note, oui/non), un modèle de décision est plus prévisible, rapide et économique. Cette famille regroupe le moteur de règles, l’arbre de décision, le classifieur et le modèle calibré comme Jev. Si une personne doit lire le résultat (une phrase, un brouillon), un grand modèle de langage s’impose. Les deux se combinent souvent dans le même processus.
Le dilemme se pose dès la première automatisation. Un grand modèle de langage (LLM) semble tout savoir faire : trier, classer, extraire, rédiger. Un modèle de décision ne fait qu’une chose : renvoyer une valeur choisie dans un cadre fixé à l’avance. La tentation est de tout confier au LLM. Elle coûte cher quand la tâche n’avait pas besoin de texte.
Le tableau ci-dessous donne la grille de lecture. Quatre critères suffisent pour une première orientation. La nature de la tâche, d’abord. La variabilité des entrées, ensuite. Puis la tolérance à l’erreur et le coût acceptable par exécution. Une cinquième ligne, la traçabilité, compte dès qu’une décision doit être expliquée à un client ou à un contrôleur. Gardez cette grille en tête, le reste de l’article la détaille.
Une précision de vocabulaire avant de continuer. « Modèle de décision » désigne ici toute brique qui renvoie une décision typée sans rédiger. Cela recouvre un moteur de règles écrit à la main, un arbre de décision ou un classifieur entraîné sur vos données. Cela recouvre aussi un modèle calibré récent comme Jev. Leur point commun : la sortie est une valeur, jamais une phrase.
| 01Critère | 02Plutôt un modèle de décision | 03Plutôt un grand modèle de langage |
|---|---|---|
| 01Nature de la tâche | Trier, noter, filtrer, valider : la réponse tient dans une liste fermée | Rédiger, résumer, reformuler, expliquer : la réponse est un texte |
| 02Variabilité des entrées | Entrées connues (formulaire, ticket, message court) avec des cas prévisibles | Entrées libres et imprévues, où il faut interpréter avant d’agir |
| 03Tolérance à l’erreur | Faible : la sortie déclenche une action sans relecture systématique | Plus élevée : une personne relit avant tout usage |
| 04Coût par exécution | Doit rester marginal, car la tâche se répète des centaines de fois | Accepté sur un volume limité, à forte valeur unitaire |
| 05Traçabilité attendue | Chaque décision doit être expliquée : règle, score ou probabilité | Une justification en texte suffit, relue par une personne |
Nature de la tâche
Variabilité des entrées
Tolérance à l’erreur
Coût par exécution
Traçabilité attendue
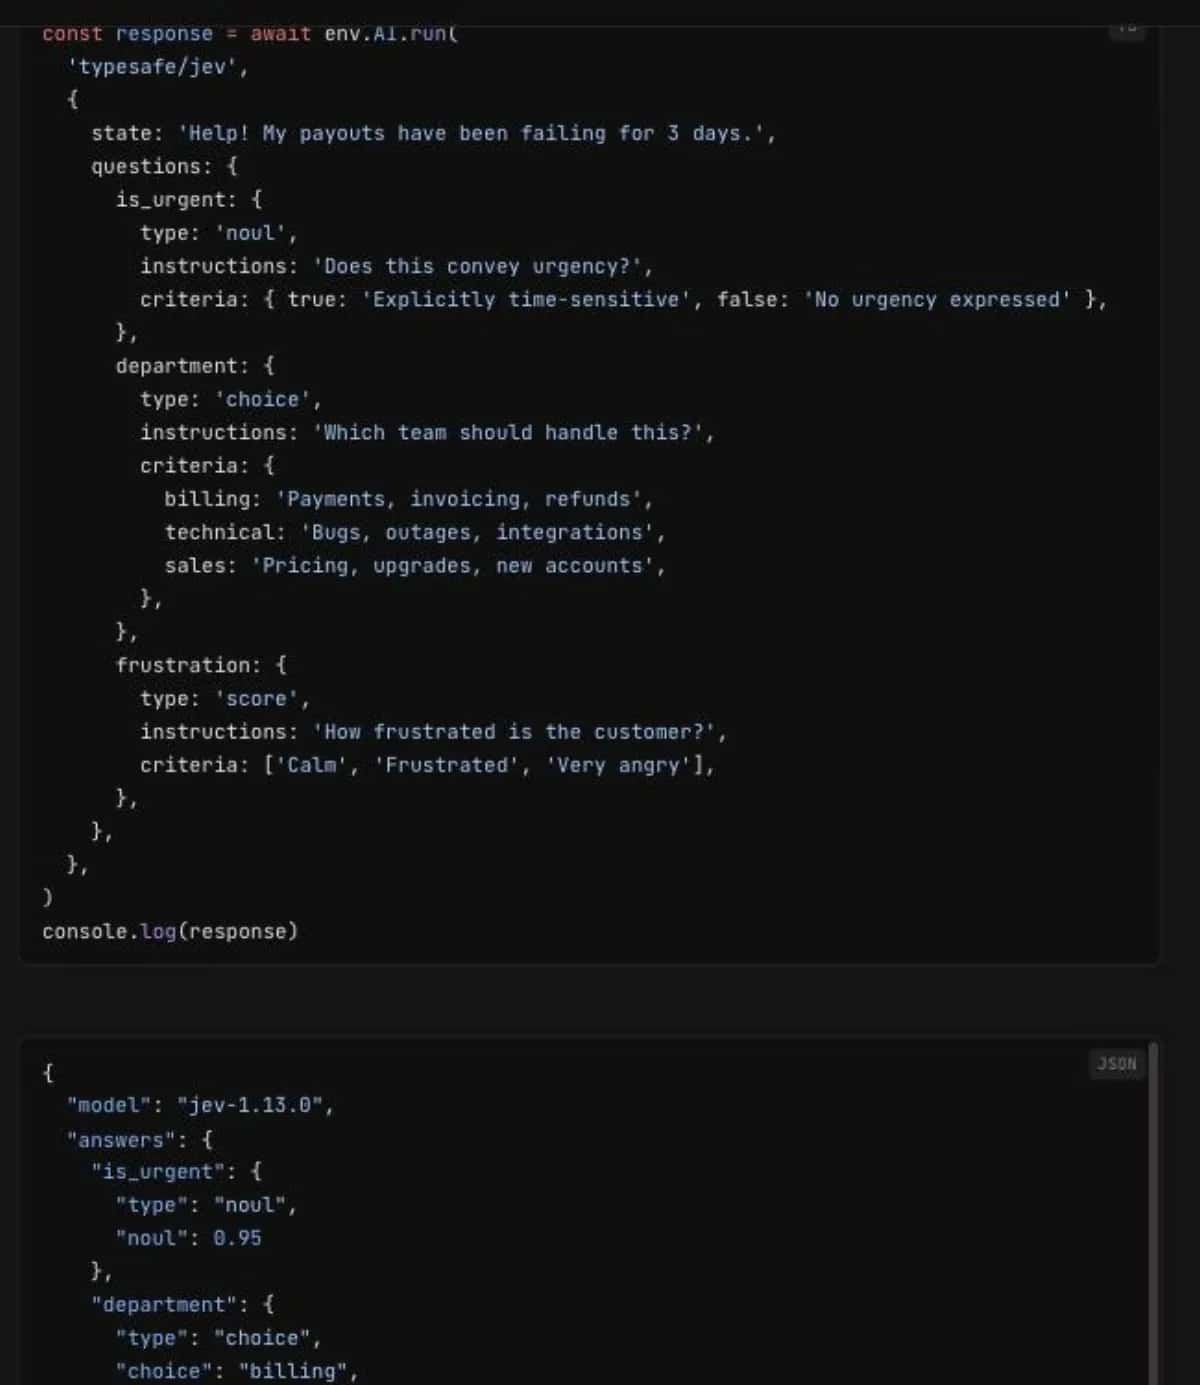
Prenez un message reçu par le service client : « Mes paiements échouent depuis trois jours ». Un LLM produit un texte : une réponse rédigée, un résumé, parfois un JSON qu’il a écrit lui-même. Un modèle de décision produit une valeur : urgence 0,95, service « facturation », niveau de frustration « frustré ». Même entrée, deux natures de sortie.
Cette différence commande tout le reste. Un texte doit être lu par une personne, ou reparsé par du code avec un risque sur la forme. Une valeur typée s’insère directement dans un test : au-dessus d’un seuil, on agit ; en dessous, on transmet à un humain. L’exemple du message de paiement vient de la fiche Cloudflare de Jev. Il est détaillé dans notre présentation du modèle de décision Jev.
Le schéma résume ce partage. En haut, l’entrée ; en dessous, deux chemins qui ne se remplacent pas. Le choix ne porte pas sur la « puissance » du modèle, mais sur ce que votre processus doit consommer ensuite. La flèche en pointillés montre le cas fréquent où un modèle de décision contrôle ce qu’un LLM a rédigé. Ce contrôle en série est souvent la meilleure façon de rendre une génération exploitable sans relire chaque texte.
Avant de comparer avec un LLM, il faut savoir de quoi la famille « modèle de décision » est faite. Quatre briques la composent, du plus simple au plus récent. Elles diffèrent par ce qu’elles demandent pour démarrer : du métier, des données historiques ou des questions bien formulées. Elles partagent la même promesse : une valeur exploitable par du code.
Une liste de conditions écrites par le métier : « si le montant dépasse le plafond, alors validation manuelle ». Le coût de calcul est négligeable et la sortie est déterministe. La décision reste lisible par n’importe qui dans l’équipe. Sa limite : chaque cas doit être prévu. Dès que les entrées sont du texte libre, les règles se multiplient puis se contredisent.
L’arbre de décision enchaîne des tests sur des critères mesurables. On peut le lire de haut en bas et expliquer chaque branche à un collègue. Le classifieur apprend sur vos exemples étiquetés, par exemple des tickets déjà triés, et renvoie une catégorie avec un score. Tous deux exigent des données historiques et un réentraînement quand le métier change.
Une famille récente, dont Jev est le premier représentant public selon son éditeur TypeSafe AI (annonce du 15 septembre 2026). Vous décrivez des questions typées, choix, score ou oui/non, avec leurs critères en langue naturelle. Le modèle renvoie une réponse et une probabilité, sans entraînement préalable. Il ne rédige pas et ne sort pas du cadre déclaré. La mise en œuvre est décrite dans notre guide Jev sur Cloudflare Workers AI.
Le LLM reste à part. Sa fonction est de générer du texte, et il peut imiter une sortie typée en écrivant du JSON. Mais cette imitation reste une génération : la forme peut dévier, une valeur peut être inventée. La capture ci-dessous montre à quoi ressemble une sortie typée réelle. Le tableau qui suit compare ensuite les deux approches critère par critère, sans chiffre inventé.
| 01Critère | 02Modèle de décision (règles, arbre, classifieur, modèle calibré) | 03Grand modèle de langage |
|---|---|---|
| 01Format de sortie | Valeur typée : catégorie, note ou probabilité, toujours dans le cadre déclaré | Texte libre ; un JSON est possible, mais généré, donc à valider |
| 02Contrôle de la sortie | Un seuil ou une comparaison suffit ; le code décide seul | Relecture humaine ou second contrôle automatique nécessaire |
| 03Latence | Immédiate pour des règles ; quelques dizaines à quelques centaines de millisecondes annoncées par l’éditeur pour Jev | Le temps de générer le texte mot à mot, généralement plus long et variable selon la longueur |
| 04Coût de calcul | Nul à marginal pour des règles ; pour Jev, l’éditeur annonce une entrée facturée et une sortie gratuite | Entrée et sortie facturées selon la grille de chaque éditeur ; le coût croît avec la longueur des textes |
| 05Dépendance au prompt | Faible : règles ou questions stables, relues avec le métier | Forte : une consigne modifiée change la sortie ; à retester à chaque changement de modèle |
| 06Traçabilité | Chaque décision se journalise avec sa règle, son score ou sa probabilité | Le texte s’explique, mais la raison du choix reste difficile à reconstituer |
| 07Hallucination | Impossible de sortir des valeurs prévues (ce qui n’est pas une garantie de justesse) | Possible : une donnée absente peut être complétée par le modèle |
Format de sortie
Contrôle de la sortie
Latence
Coût de calcul
Dépendance au prompt
Traçabilité
Hallucination
Sur le terrain, la victoire du modèle de décision tient à quatre propriétés. Le coût de calcul, la prévisibilité de la sortie, l’absence d’hallucination et la traçabilité. Elles comptent surtout quand la tâche se répète des centaines de fois par jour et que personne ne relit chaque résultat. Trois tâches d’entreprise le montrent.
Tri de tickets. Une demande arrive, il faut la router vers le bon service. Un classifieur entraîné sur vos tickets passés, ou une question typée, renvoie le service et l’urgence avec un score. Le LLM peut le faire, mais vous payez une génération de texte pour obtenir un mot. Et ce mot varie avec la consigne.
Extraction de champs. Un numéro de commande, une date, un montant. Si le format est stable, une facture fournisseur récurrente par exemple, une règle ou une expression régulière est imbattable. Si le format varie ou si l’information est noyée dans un texte libre, le LLM devient utile. À une condition : valider chaque champ extrait par une règle avant de l’enregistrer.
Scoring. Donner une note de complétude à un dossier ou une priorité à un lead. La note doit rester comparable d’un dossier à l’autre. Un arbre de décision ou un score calibré le garantit. Un LLM qui « donne une note sur dix » change d’avis selon la formulation de la demande.
La traçabilité pèse aussi sur le plan réglementaire. L’AI Act classe à haut risque des usages comme le tri de CV ou la notation de crédit. Pour ces systèmes, les obligations de journalisation et de surveillance humaine s’appliquent à compter du 2 décembre 2027. La date est celle affichée par la page officielle de la Commission européenne. Une décision typée se journalise ; un texte se relit. Notre guide AI Act pour les entreprises détaille ce calendrier.
| 01Situation | 02Sortie attendue | 03Choix recommandé | 04Pourquoi |
|---|---|---|---|
| 01Tri de leads entrants | Une priorité et un service | Modèle de décision | Liste fermée, gros volume, seuil d’action. Le LLM n’apporterait qu’un mot, plus cher et moins stable |
| 02Modération de contenus | Publier, retenir ou escalader | Modèle de décision, avec relecture humaine sous le seuil | Trois options, décision journalisée ; la zone d’incertitude part en relecture au lieu d’être tranchée au hasard |
| 03Extraction de champs | Des valeurs : date, montant, référence | Règle si le format est stable ; LLM puis validation par règle si le texte est libre | Le LLM sait lire l’imprévu, la règle garantit la forme de chaque champ |
| 04Rédaction d’une réponse | Un texte lisible par le client | LLM, avec relecture humaine | Seule brique capable de produire une phrase adaptée ; un modèle de décision peut vérifier une règle avant l’envoi |
Tri de leads entrants
Modération de contenus
Extraction de champs
Rédaction d’une réponse
Un grand modèle de langage s’impose dès que la sortie est destinée à une personne. Réponse client, compte rendu, résumé d’un document, reformulation d’une demande floue : autant de textes qu’aucune règle ne produira correctement. Il est aussi le seul à interpréter une entrée imprévue, comme une référence citée au milieu d’un message. Ces usages justifient son coût et sa relecture.
Le cadrage d’un LLM passe par la consigne. Rôle, matière fournie, format attendu, critère de refus : la méthode est décrite dans notre trame de prompt IA pour l’entreprise. Elle réduit les dérives sans les supprimer. C’est pourquoi une relecture, humaine ou par une règle, reste nécessaire après chaque génération.
Demander à un LLM une catégorie qu’un modèle de décision aurait renvoyée directement coûte cher à l’usage. Vous ajoutez un prompt à maintenir, une latence, un coût par appel et une sortie à valider. Le symptôme est connu : un parseur JSON qui échoue de temps en temps. Et une équipe qui passe ses semaines à « corriger le prompt » au lieu d’améliorer le processus.
Un moteur de règles qui assemble des bouts de texte donne des réponses rigides et difficiles à maintenir. Il est incapable d’interpréter le contexte d’une demande. Quand la tâche exige une phrase adaptée à la situation, le LLM est le bon outil, à condition d’organiser sa relecture.
La combinaison est souvent la bonne réponse. Le modèle de décision trie et route. Le LLM prépare un brouillon. Un second modèle de décision vérifie une règle avant l’envoi. Cette chaîne est celle d’un agent IA en entreprise bien cadré : des décisions typées autour d’une génération contrôlée.
Les tableaux précédents orientent, ils ne tranchent pas à votre place. Deux entreprises qui trient des demandes n’ont ni les mêmes messages, ni la même tolérance à l’erreur. Le seul arbitre fiable est un essai sur vos propres cas, avec une référence écrite avant de lancer les outils.
Le choix ne se fait pas sur une fiche technique, mais sur vos données. Une demi-journée suffit pour une première comparaison honnête, sans développement lourd. L’objectif n’est pas de mesurer une précision absolue. Il est de voir où chaque approche se trompe, et si elle le signale.
Choisissez une tâche étroite : router des demandes entre trois services, ou décider si un avis peut être publié. Rassemblez une trentaine de cas réels, anonymisés, en incluant des cas ambigus. Écrivez la réponse attendue à la main avant de lancer quoi que ce soit. C’est votre référence, et elle vaut plus que n’importe quel score affiché par un outil.
Comparez ensuite trois approches sur les mêmes cas. Des règles simples, écrites en une heure. Un LLM avec une consigne contrainte. Un modèle de décision calibré, si vous disposez d’un compte Cloudflare. La mise en place de Jev sur Workers AI tient dans quelques lignes de configuration. Notez les désaccords avec votre référence, pas seulement le taux de réussite.
Le résultat qui compte : où sont les erreurs, et sont-elles signalées ? Une approche qui se trompe en annonçant une probabilité faible vaut mieux qu’une approche qui se trompe avec assurance. C’est la base d’une automatisation des tâches où la relecture humaine se concentre sur les cas douteux. Les étapes ci-dessous détaillent le déroulé.
Étape 1
Une seule tâche, dont la réponse tient dans une liste : trois services, deux niveaux d’urgence, publier ou retenir. Écrivez la liste avant tout le reste.
Étape 2
Des messages ou dossiers récents, anonymisés, avec des cas nets et des cas ambigus. Notez à la main la réponse attendue pour chacun : c’est la référence.
Étape 3
Mots-clés, montants, champs présents ou absents. Une heure, pas plus. Cette base montre jusqu’où un moteur de règles suffit sans aucun modèle.
Étape 4
Rôle, matière, format imposé, critère de refus. Passez les mêmes cas et relevez les sorties hors format autant que les erreurs de fond.
Étape 5
Déclarez les mêmes questions en type choix, score ou oui/non, avec leurs critères. Relevez la valeur et la probabilité renvoyées pour chaque cas.
Étape 6
Listez les cas où chaque approche diverge de la référence. Choisissez le seuil de probabilité en dessous duquel une personne reprend la main.
Tout l’article tient dans cette question. Si la sortie est consommée par du code, il faut une valeur typée, donc un modèle de décision. Un test, un routage ou un seuil ne savent rien faire d’une phrase. Des règles quand les cas sont connus et peu nombreux. Un classifieur ou un arbre de décision quand vous disposez d’un historique étiqueté. Un modèle calibré quand les entrées sont du texte libre et que vous n’avez ni données ni temps d’entraînement.
Si la sortie est lue par une personne, il faut un texte, donc un LLM. Il est cadré par une consigne et suivi d’une relecture. Et si le processus mêle les deux, découpez-le : chaque étape reçoit sa brique. Le LLM, plus coûteux et plus lent, n’intervient que là où une phrase est réellement utile.
Ce critère évite l’opposition artificielle entre « IA générative » et « alternative aux LLM ». Automatiser une tâche sans intelligence artificielle générative est possible, et souvent préférable, quand la réponse tient dans une liste. Recourir à un LLM est justifié quand il faut écrire. La bonne question n’est pas « quel modèle est le plus fort », mais « qui lit la sortie ». L’arbre ci-dessous et la grille qui suit résument la décision.
Le découpage par étape est un travail de métier autant que de technique. Formuler les questions, choisir les seuils, organiser la relecture : ces choix appartiennent à l’équipe qui traite les dossiers. C’est l’un des sujets du parcours IA de La Refonte. Deux jours pour travailler le prompting, les automatisations no-code et les garde-fous à partir de vos cas réels.
Pour comparer les différents modèles d’IA entre eux, notre panorama complet des modèles IA prolonge cette lecture. Il situe les grandes familles de modèles et leurs usages. Une fois la question « qui lit la sortie » tranchée pour votre tâche, ce panorama aide à choisir le modèle lui-même.
Dernière mise à jour : Septembre 2026
Le parcours IA de La Refonte travaille vos cas réels : quelle étape trier, quelle étape rédiger, où placer la relecture. Programme et modalités sur la page de la formation.
Pour aller plus loin

Sans engagement, sans jargon
Trente minutes pour identifier ce qui freine votre visibilité et repartir avec les priorités dans le bon ordre.
Discutons de votre projet
30 min · Google Meet
Choisissez le créneau qui vous convient dans notre calendrier. On analyse votre situation avant l’appel pour aller droit au but.
Recherche des créneaux disponibles...