Refonte
Le carnet de La Refonte
Le code officiel pour appeler le modèle de décision Jev depuis un Worker Cloudflare, les seuls chiffres publics disponibles et ce qu’il faut vérifier avant la production.
Refonte
WordPress
SEO
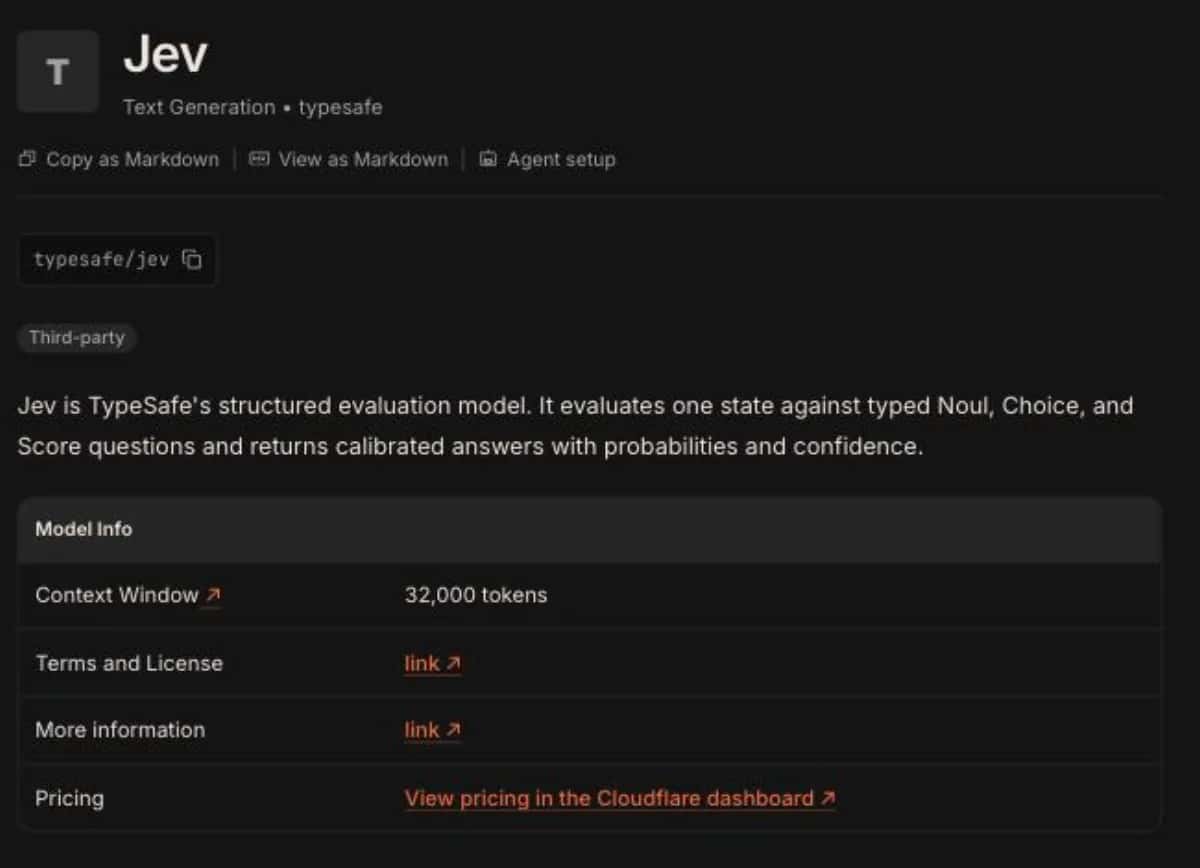
Jev, le modèle de décision de TypeSafe AI, est disponible sur Cloudflare Workers AI sous l’identifiant « typesafe/jev ». Un Worker déclare un binding AI, envoie un état et des questions typées, puis reçoit des probabilités et une confiance. Ce guide reprend le code officiel de Cloudflare et les seuls chiffres publics disponibles, relevés sur la démo askjev.ai. La Refonte n’a pas encore exécuté Jev depuis son propre Worker.
Jev est le modèle de décision annoncé par TypeSafe AI le 15 septembre 2026. Il ne rédige pas : il évalue un état, message ou objet, contre des questions typées et renvoie des probabilités. Cloudflare le propose comme modèle tiers dans Workers AI, sous l’identifiant « typesafe/jev ». Le fonctionnement général est détaillé dans notre article sur le modèle Jev.
Ce guide suit la fiche modèle publiée par Cloudflare, consultée le 19 septembre 2026. Les extraits de code en sont repris tels quels. Une précision s’impose : La Refonte n’a pas encore exécuté Jev depuis son propre Worker. Les seuls chiffres réels de cet article viennent de la démo publique askjev.ai, relevés les 18 et 19 septembre 2026.
Pourquoi un guide malgré tout ? La documentation officielle décrit le produit sans cas d’usage complet. Ici, le fil conducteur est un besoin métier courant : trier les messages entrants d’un service client. Le circuit tient en quatre étapes, illustrées ci-dessous, avant les vérifications à faire chez vous.
Workers AI exécute des modèles sur les GPU du réseau Cloudflare, au plus près de l’utilisateur. C’est l’inférence IA à la périphérie : le Worker et le modèle tournent dans le même réseau, sans serveur à gérer. Le GPU est serverless : vous payez l’usage, pas la machine. Le modèle s’appelle par une simple API, depuis le code du Worker ou par requête REST.
La tarification Workers AI repose sur une unité, le Neuron, qui mesure le calcul GPU consommé par une requête. Selon la page de tarification consultée le 19 septembre 2026, chaque compte dispose de 10 000 Neurons gratuits par jour. Au-delà, le plan Workers Paid facture 0,011 $ par tranche de 1 000 Neurons.
Pour Jev, la fiche modèle renvoie au tableau de bord Cloudflare pour le prix : il n’est pas affiché publiquement. TypeSafe AI annonce de son côté, au lancement, 0,042 $ par million de tokens en entrée et une sortie gratuite. Vérifiez le montant réel dans votre tableau de bord avant de dimensionner un volume.
| 01Ce que vous consommez | 02Ce que dit la source | 03Source et date |
|---|---|---|
| 01Allocation gratuite Workers AI | 10 000 Neurons par jour, sans frais | Cloudflare, tarification, 19/09/2026 |
| 02Au-delà de l’allocation | 0,011 $ par 1 000 Neurons (plan Workers Paid) | Cloudflare, tarification, 19/09/2026 |
| 03Modèle typesafe/jev sur Workers AI | Tarif affiché dans le tableau de bord, non public | Cloudflare, fiche modèle, 19/09/2026 |
| 04Jev via l’API TypeSafe | 0,042 $ par million de tokens en entrée, sortie gratuite, au lancement | TypeSafe AI, 15/09/2026 |
Allocation gratuite Workers AI
Au-delà de l’allocation
Modèle typesafe/jev sur Workers AI
Jev via l’API TypeSafe
Un Worker accède aux modèles par un « binding » nommé AI, déclaré dans le fichier de configuration wrangler.toml. Une fois le projet déployé, l’objet env.AI expose la méthode run. Elle prend l’identifiant du modèle et ses paramètres. Prérequis : un compte Cloudflare avec Workers AI activé et l’outil en ligne de commande Wrangler. Aucune clé API TypeSafe n’est nécessaire : le modèle est routé par la plateforme.
[ai]
binding = "AI"Jev attend deux éléments : un « state », chaîne ou objet à évaluer, et un objet « questions ». Chaque question porte un type, une consigne (« instructions ») et des critères. Trois types existent. « Noul » répond par une probabilité entre 0 et 1. « Choice » retient une option parmi celles que vous décrivez. « Score » place l’état sur une échelle ordonnée.
L’exemple officiel traite un message de support. Trois questions sont posées en un seul appel : l’urgence, le service compétent et le niveau d’agacement. Les critères sont rédigés en anglais dans la documentation. La fiche limite le contexte à 32 000 tokens : un long historique doit être résumé avant l’appel.
const response = await env.AI.run(
  'typesafe/jev',
  {
    state: 'Help! My payouts have been failing for 3 days.',
    questions: {
      is_urgent: {
        type: 'noul',
        instructions: 'Does this convey urgency?',
        criteria: { true: 'Explicitly time-sensitive', false: 'No urgency expressed' },
      },
      department: {
        type: 'choice',
        instructions: 'Which team should handle this?',
        criteria: {
          billing: 'Payments, invoicing, refunds',
          technical: 'Bugs, outages, integrations',
          sales: 'Pricing, upgrades, new accounts',
        },
      },
      frustration: {
        type: 'score',
        instructions: 'How frustrated is the customer?',
        criteria: ['Calm', 'Frustrated', 'Very angry'],
      },
    },
  },
)
console.log(response)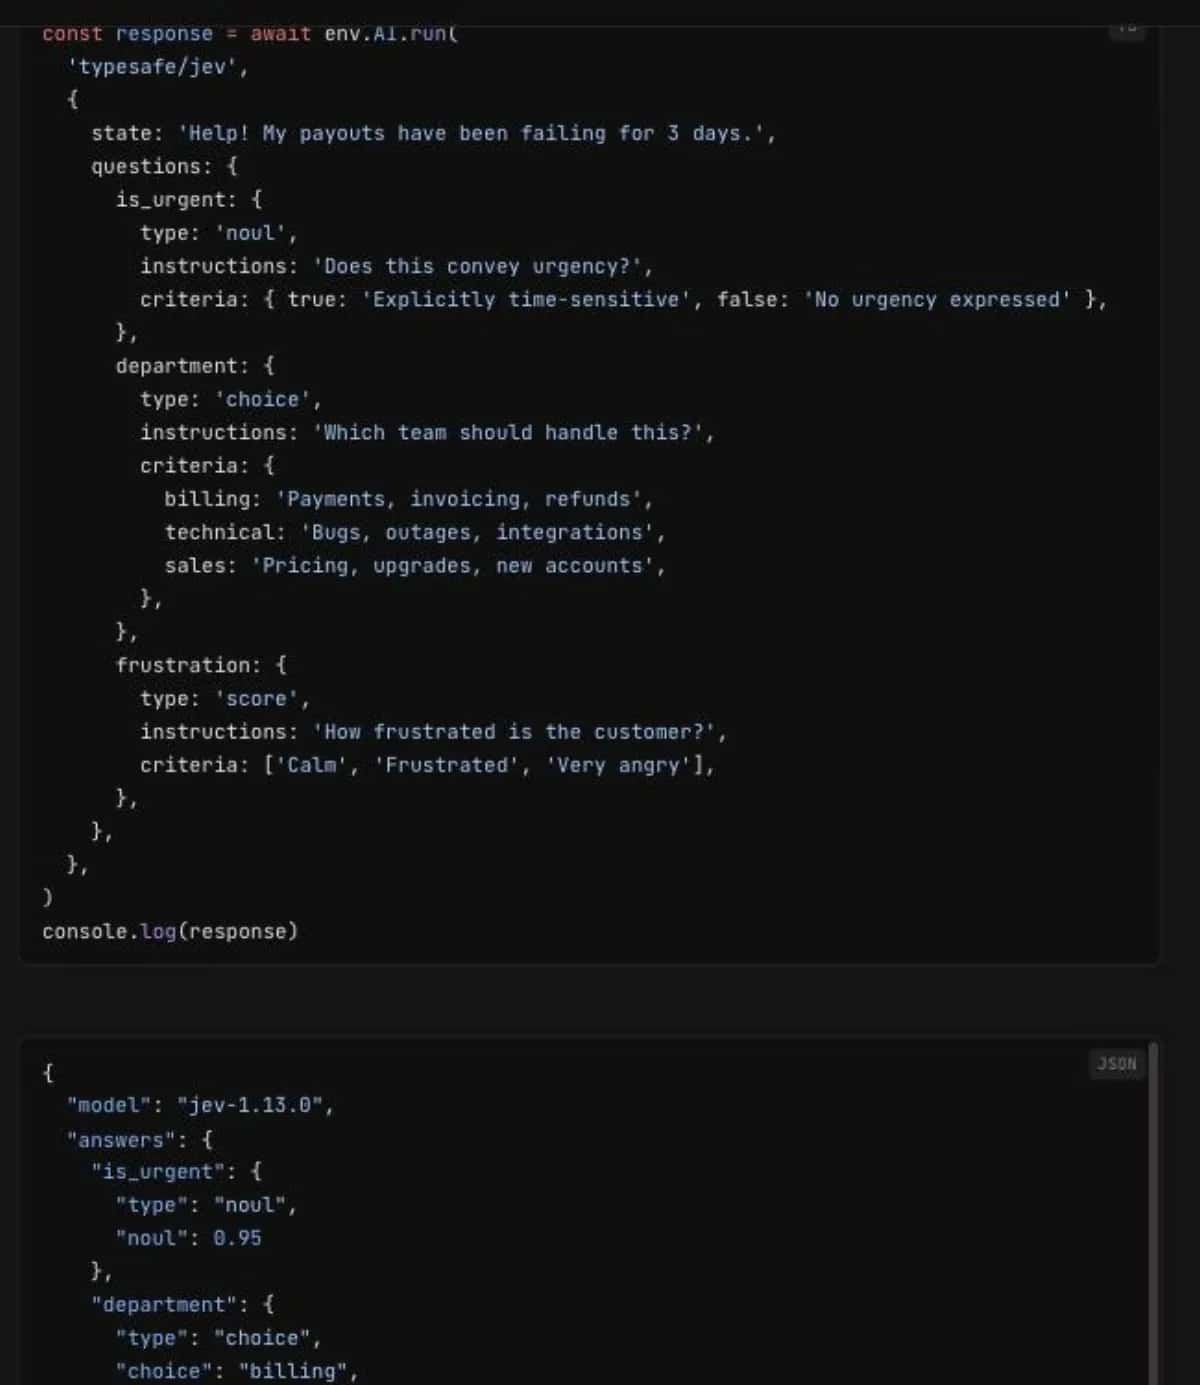
La réponse contient un champ « answers », avec une entrée par question, et un champ « usage » qui compte les tokens. Un « noul » renvoie une probabilité. Un « choice » renvoie l’option retenue, une confiance et la probabilité de chaque option. Un « score » renvoie une valeur sur l’échelle, sa légende et la répartition des probabilités.
Dans l’exemple, le message est jugé urgent à 0,95 et affecté à la facturation avec une confiance de 0,8. L’appel a consommé 426 tokens en entrée et 73 en sortie. Le modèle indiqué est jev-1.13.0 ; cette version peut changer, le modèle est récent.
{
  "model": "jev-1.13.0",
  "answers": {
    "is_urgent": { "type": "noul", "noul": 0.95 },
    "department": {
      "type": "choice",
      "choice": "billing",
      "confidence": 0.8,
      "probabilities": { "billing": 0.87, "sales": 0, "technical": 0.13 }
    },
    "frustration": {
      "type": "score",
      "score": 1.04,
      "confidence": 0.94,
      "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
      "probabilities": { "0": 0, "1": 0.96, "2": 0.04 }
    }
  },
  "usage": { "input_tokens": 426, "output_tokens": 73 }
}Jev ne prend pas la décision finale : votre code la prend. La règle la plus simple est un seuil de confiance. Au-dessus, le Worker agit : il route le message ou étiquette le dossier. En dessous, il transmet le cas à une personne, avec les probabilités jointes pour faciliter l’arbitrage.
Le seuil dépend du coût d’une erreur. Router un message vers le mauvais service se corrige en une minute. Déclencher un remboursement, non. Commencez haut, observez les cas transmis en relecture, puis ajustez avec l’équipe concernée. L’extrait ci-dessous n’est pas du code officiel : c’est une proposition de La Refonte, à adapter à vos fonctions.
const { department, is_urgent } = response.answers
const SEUIL = 0.85

if (department.confidence >= SEUIL) {
  await routeTo(department.choice, { urgent: is_urgent.noul >= 0.8 })
} else {
  await sendToHumanReview({ message, answers: response.answers })
}Le « state » peut être un objet. C’est utile quand la décision dépend de plusieurs sources : le message du client, la commande concernée et la règle interne. Les consignes des questions peuvent alors désigner les champs de l’objet. L’exemple officiel ci-dessous évalue une double facturation contre une politique de remboursement, en deux questions « noul ».
const response = await env.AI.run(
  'typesafe/jev',
  {
    state: {
      ticket: {
        subject: 'Duplicate charge',
        message: 'I was charged twice for order A-104. Please refund the duplicate.',
      },
      order: {
        id: 'A-104',
        charges: [
          { amount_usd: 49, status: 'captured' },
          { amount_usd: 49, status: 'captured' },
        ],
      },
      refund_policy: 'Duplicate charges are eligible for a refund.',
    },
    questions: {
      refund_requested: { type: 'noul', instructions: 'Does `ticket.message` request a refund?' },
      policy_supports_refund: {
        type: 'noul',
        instructions:
          'Does `refund_policy` support the refund requested in `ticket.message`, given `order.charges`?',
      },
    },
  },
)askjev.ai est une démo publique construite sur Convex et l’API TypeSafe, non affiliée à l’éditeur. Elle pose six questions typées à Jev pour chaque message et affiche la latence et le coût rapportés par son serveur. Le 18 septembre 2026 à 20 h 17 UTC, 172 appels étaient lisibles sur son mur public.
Latence sur ces 172 appels : 117 ms au minimum, 188 ms en médiane, 395 ms au 95e centile. Le maximum atteint 622 ms. Coût affiché : 18 442 messages pour 0,8191 $, soit 0,0000444 $ par appel. Cela représente environ 1 057 tokens en entrée par message. Le 19 septembre, le compteur indiquait 18 870 messages pour 0,8385 $.
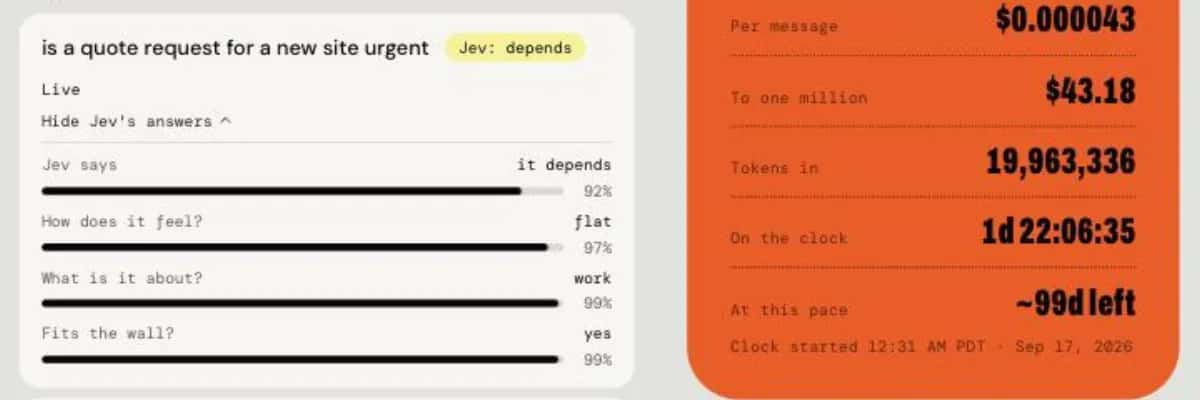
Notre test du 19 septembre porte sur la question « is a quote request for a new site urgent ». Verdict : « it depends » à 92 %, ton « flat » à 97 %, sujet « work » à 99 %. Formulée sans contexte, la question est réellement ambiguë et le modèle le dit par sa probabilité. C’est le cas typique où le seuil renvoie vers une personne.
Trois limites à garder en tête. Les questions sont fixées par la démo, pas par votre schéma service, urgence, ton. La démo n’accepte que des mots anglais : c’est un filtre de l’application, pas une limite documentée de Jev. Enfin, la latence est celle du serveur de la démo, pas celle d’un Worker chez vous.
| 01Centile | 02Latence relevée | 03Lecture pour un Worker |
|---|---|---|
| 01Minimum | 117 ms | Plancher observé, hors réseau client |
| 0225e centile | 156 ms | Un quart des appels sous 0,16 s |
| 03Médiane | 188 ms | La moitié des appels sous 0,19 s |
| 0475e centile | 283 ms | Trois quarts des appels sous 0,29 s |
| 0595e centile | 395 ms | Repère pour fixer un délai d’attente |
| 06Maximum | 622 ms | Prévoir une reprise si le modèle ne répond pas |
Minimum
25e centile
Médiane
75e centile
95e centile
Maximum
Au vu de la documentation et des relevés, Jev sur Workers AI convient aux décisions fermées, fréquentes et réversibles : trier, prioriser, étiqueter. Il ne remplace ni un modèle de langage pour rédiger, ni une personne pour trancher un cas ambigu. La place d’un tel modèle dans un processus plus large est décrite dans notre article sur les agents IA en entreprise.
Le modèle étant un service tiers, vérifiez où transitent les données. Un message client peut contenir des informations personnelles : n’envoyez que ce qui sert la décision. Les conditions d’utilisation du modèle sont celles de TypeSafe AI, référencées sur la fiche Cloudflare. Le tableau et la liste ci-dessous résument ce qu’il faut cadrer avant la production.
| 01Prêt pour | 02Pas prêt pour | 03Pourquoi |
|---|---|---|
| 01Router un message vers le bon service | Rédiger la réponse au client | Jev évalue, il ne génère pas de texte |
| 02Prioriser une file de tickets | Déclencher un remboursement sans relecture | Une erreur irréversible exige une personne |
| 03Étiqueter un ton ou une urgence | Trancher un cas que le modèle juge ambigu | Sous le seuil, la probabilité dit « it depends » |
| 04Un pilote avec journal des décisions | Un volume dimensionné sur un prix supposé | Le tarif Jev sur Cloudflare n’est pas public |
| 05Des consignes testées sur vos messages | Une généralisation en français sans test | La documentation ne montre que de l’anglais |
Router un message vers le bon service
Prioriser une file de tickets
Étiqueter un ton ou une urgence
Un pilote avec journal des décisions
Des consignes testées sur vos messages
Pour comparer cette approche à d’autres modèles IA disponibles, direction le comparatif des modèles IA. Pour choisir l’outil adapté à chaque étape d’un processus, lisez modèle de décision ou LLM. Pour apprendre à cadrer ce type d’automatisation avec ses garde-fous, le parcours IA de La Refonte en présente le programme.
Dernière mise à jour : 19 septembre 2026
La Refonte accompagne les équipes qui veulent brancher une décision IA sur un processus réel, avec seuil, journal et relecture humaine.
Pour aller plus loin

Sans engagement, sans jargon
Trente minutes pour identifier ce qui freine votre visibilité et repartir avec les priorités dans le bon ordre.
Discutons de votre projet
30 min · Google Meet
Choisissez le créneau qui vous convient dans notre calendrier. On analyse votre situation avant l’appel pour aller droit au but.
Recherche des créneaux disponibles...