Refonte
Le carnet de La Refonte
Ce que fait Jev, le modèle de décision de TypeSafe AI : un choix, un score ou une probabilité à la place d’un texte, et sa place dans un workflow.
Refonte
SEO
IA
Jev est un modèle d’IA édité par TypeSafe AI et présenté comme un « System One model ». Il ne rédige pas de texte. Il évalue une situation que vous lui donnez et répond par une décision structurée. Cette réponse est un choix parmi vos options, une note sur une échelle ou une probabilité. Chaque réponse est accompagnée d’un niveau de confiance. Il s’insère dans un workflow automatisé pour trier, filtrer ou classer, là où un grand modèle de langage rédige.
Jev est un modèle d’intelligence artificielle publié par TypeSafe AI, une jeune entreprise de San Francisco. L’annonce figure sur le site de l’éditeur à la date du 15 septembre 2026. La presse spécialisée l’a relayée le 16 septembre. La société est dirigée par Diogo Almeida, ancien chercheur d’OpenAI, et a levé 40 millions de dollars en amorçage auprès de DCVC.
Ce que Jev fait tient en une phrase. Il reçoit une situation, la compare à des questions que vous avez formulées, puis renvoie une décision structurée. Une décision structurée est une réponse dans un format fixé d’avance. Ce format est une option parmi une liste, une position sur une échelle ou une probabilité. Ce n’est jamais un paragraphe.
Un grand modèle de langage, comme ceux qui font tourner les assistants conversationnels, produit une réponse mot après mot. Jev ne produit pas de texte. Il remplit des cases que vous avez dessinées et indique, pour chacune, sa confiance chiffrée. Cette différence explique l’intérêt des équipes qui automatisent des flux de travail.
TypeSafe AI range Jev dans une catégorie qu’il nomme « System One model ». L’expression renvoie à la pensée rapide et intuitive décrite par Daniel Kahneman, par opposition à la pensée lente et délibérée. L’éditeur ne développe pas le nom « Jev » lui-même. Aucune signification n’apparaît dans les documents consultés, et cet article n’en invente pas.
Pour un lecteur pressé : Jev est un modèle de décision, pas un modèle de génération de texte. Il choisit, note ou estime dans un cadre que vous avez fixé. Il dit aussi à quel point il est sûr de sa réponse.
L’appel se prépare en deux temps. Vous décrivez d’abord les questions et les valeurs possibles de chaque réponse. Vous fournissez ensuite un « état » : le texte d’une demande client, un dossier structuré, une commande. Le modèle évalue toutes les questions en parallèle et renvoie un champ par question.
Trois types de questions existent. « Choice » sélectionne une option parmi une liste que vous décrivez, avec la probabilité de chaque option. « Score » place l’état sur une échelle ordonnée que vous définissez. « Noul » répond à une question fermée par une probabilité comprise entre 0 et 1.
Chaque réponse porte une probabilité et, pour les choix et les scores, une confiance. Ces chiffres ne sont pas décoratifs : ils servent à décider si le résultat est assez sûr pour agir sans relecture. L’éditeur nomme son architecture RLCD, pour « Reinforcement Learning for Calibrated Decisions ». La calibration des probabilités est présentée comme l’objectif central.
L’état n’est pas forcément un texte. Il peut être un objet structuré : une commande avec ses champs, un dossier avec ses pièces, une fiche client. Le modèle évalue alors les questions sur l’ensemble des champs fournis. Cette souplesse évite de rédiger un résumé intermédiaire avant la décision.
Dans l’exemple officiel publié par Cloudflare, le message d’un client signale des paiements en échec depuis trois jours. Trois questions sont posées : l’urgence (Noul), le service compétent (Choice) et le niveau d’agacement (Score). La réponse indique une urgence à 0,95 et attribue la demande au service facturation.
| 01Type | 02Vous déclarez | 03Jev renvoie | 04Exemple officiel |
|---|---|---|---|
| 01Choice | Une liste d’options décrites en langage courant | L’option retenue, sa confiance et la probabilité de chaque option | Quel service traite cette demande : facturation, technique, commercial ? |
| 02Score | Une échelle ordonnée | Une position sur l’échelle, sa confiance et la répartition des probabilités | Niveau d’agacement du client, de « calme » à « très en colère » |
| 03Noul | Une question fermée avec ses critères vrai / faux | Une probabilité entre 0 et 1 | Cette demande exprime-t-elle une urgence ? |
Choice
Score
Noul
Un grand modèle de langage peut lui aussi renvoyer un format structuré, par exemple du JSON. Il le génère cependant comme du texte, mot après mot. La forme peut dévier, une option absente de votre liste peut apparaître et une valeur peut être inventée. C’est le mécanisme de l’hallucination.
Jev ne génère pas de prose. Il ne peut répondre que dans le cadre des valeurs déclarées. « Sans hallucination », dans ce contexte, signifie qu’il ne sort pas du cadre. Cela ne signifie pas que la décision est juste : une probabilité de 0,6 sur la mauvaise option reste une erreur.
Le terme le plus proche est celui de classificateur, avec deux différences. Le modèle n’est pas entraîné sur vos catégories : vous les décrivez en langage courant à chaque appel. Et il renvoie une probabilité calibrée plutôt qu’une simple étiquette. Le choix entre les deux familles est détaillé dans notre comparaison modèle de décision ou LLM.
Les chiffres mis en avant au lancement viennent de l’éditeur. TypeSafe AI annonce des réponses en quelques dizaines à quelques centaines de millisecondes. Il affiche un prix d’entrée de 0,042 dollar par million de tokens, avec une sortie gratuite. Ces valeurs n’ont pas été mesurées par La Refonte sur sa propre infrastructure.
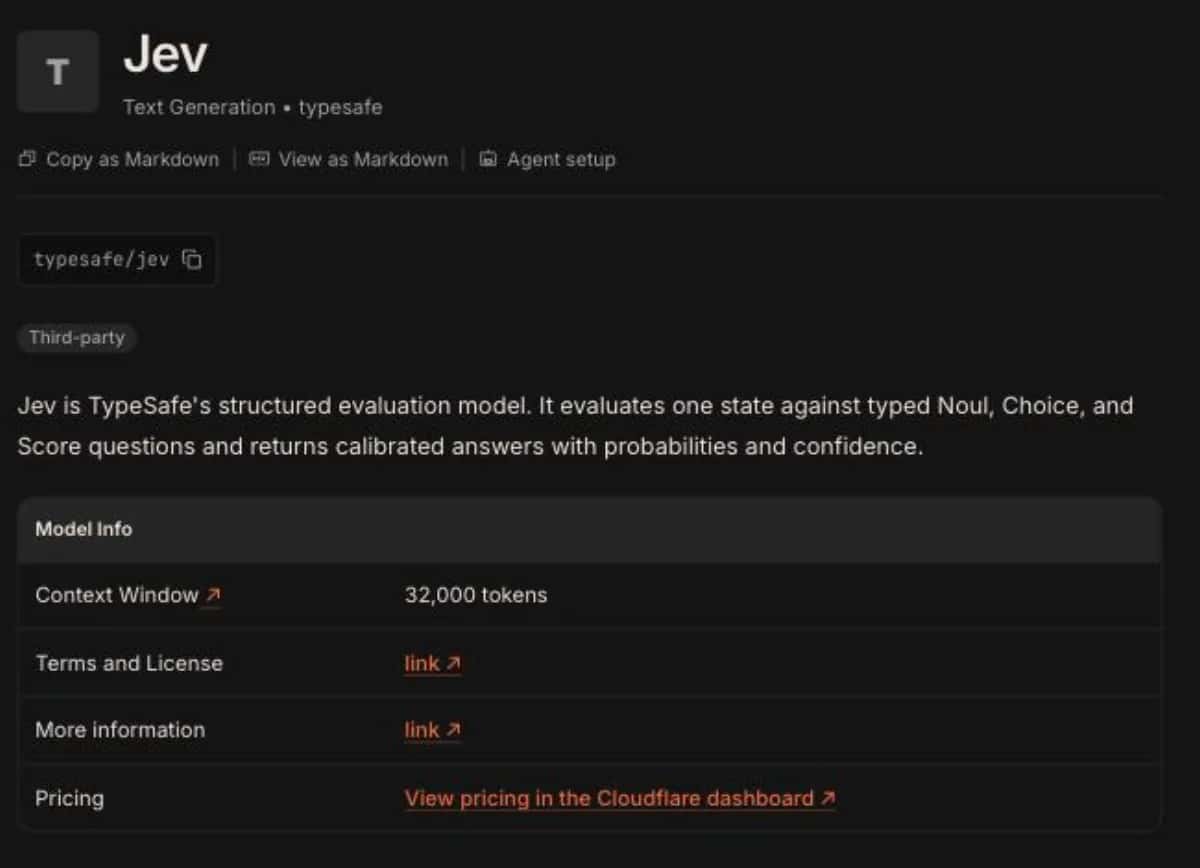
Jev est proposé comme modèle tiers sur Cloudflare Workers AI, sous l’identifiant « typesafe/jev ». La fiche officielle, consultée le 19 septembre 2026, le classe dans la catégorie « Text Generation » malgré sa nature. Elle décrit un « modèle d’évaluation structurée » qui renvoie des réponses calibrées avec probabilités et confiance. Elle indique une fenêtre de contexte de 32 000 tokens et renvoie vers le tableau de bord Cloudflare pour le tarif. La version renvoyée dans l’exemple est « jev-1.13.0 ».
L’appel tient en quelques lignes. Un binding « AI » est déclaré dans la configuration du Worker. Le code appelle ensuite env.AI.run avec l’état et les questions. Aucune clé API TypeSafe n’est nécessaire dans ce cas, la plateforme route l’appel. Le code ci-dessous est repris tel quel de la fiche modèle.
Déploiement, lecture des probabilités et règle de seuil sont détaillés dans notre guide pour utiliser Jev sur Cloudflare Workers AI. Le présent article se limite à la compréhension du modèle.
const response = await env.AI.run(
  'typesafe/jev',
  {
    state: 'Help! My payouts have been failing for 3 days.',
    questions: {
      is_urgent: {
        type: 'noul',
        instructions: 'Does this convey urgency?',
        criteria: { true: 'Explicitly time-sensitive', false: 'No urgency expressed' },
      },
      department: {
        type: 'choice',
        instructions: 'Which team should handle this?',
        criteria: {
          billing: 'Payments, invoicing, refunds',
          technical: 'Bugs, outages, integrations',
          sales: 'Pricing, upgrades, new accounts',
        },
      },
      frustration: {
        type: 'score',
        instructions: 'How frustrated is the customer?',
        criteria: ['Calm', 'Frustrated', 'Very angry'],
      },
    },
  },
)
console.log(response)Une petite entreprise n’a pas besoin d’un modèle qui écrit à sa place pour automatiser utilement. Elle a souvent besoin d’un tri fiable au milieu d’un flux : demandes entrantes, documents reçus, réponses produites par un autre outil. C’est précisément la place d’un modèle de décision.
Premier cas, le tri des demandes. Un formulaire de contact, une boîte e-mail partagée ou un chat reçoivent des messages variés. Le modèle décide du service concerné et du niveau d’urgence. Le workflow route ensuite chaque message sans qu’une personne relise tout.
Deuxième cas, le contrôle d’une sortie IA avant envoi. Un assistant a rédigé une réponse à partir d’un dossier. Une question « cette réponse cite-t-elle une source du dossier ? » renvoie une probabilité. En dessous d’un seuil, la réponse part en relecture humaine. Ce schéma fait partie des garde-fous décrits dans notre article sur l’agent IA en entreprise.
Troisième cas, le volume de petites décisions répétitives. Il s’agit de classer des factures fournisseurs, de noter la complétude d’un dossier ou de repérer les avis clients à traiter vite. Chaque décision est modeste, mais le volume justifie l’outillage.
Côté outillage, un modèle de ce type s’appelle par une requête API. Il s’insère donc dans un scénario n8n ou Make, ou dans une fonction hébergée, entre le déclencheur et l’action. Aucun développement lourd n’est nécessaire pour un premier test. Le temps se passe surtout à décrire les options et leurs critères avec l’équipe.
Dans les trois cas, le modèle n’est qu’une étape. Le déclencheur, la règle de seuil, la reprise des erreurs et la supervision restent à construire. Notre guide sur l’automatisation des tâches distingue ce qui peut être délégué de ce qui doit rester sous contrôle.
Une démonstration publique, askjev.ai, permet de soumettre une question en anglais à Jev. Elle n’est pas éditée par TypeSafe AI : elle s’appuie sur l’API de l’éditeur et sur Convex. Les questions posées au modèle sont fixées par la démo, au nombre de six, et ne se modifient pas.
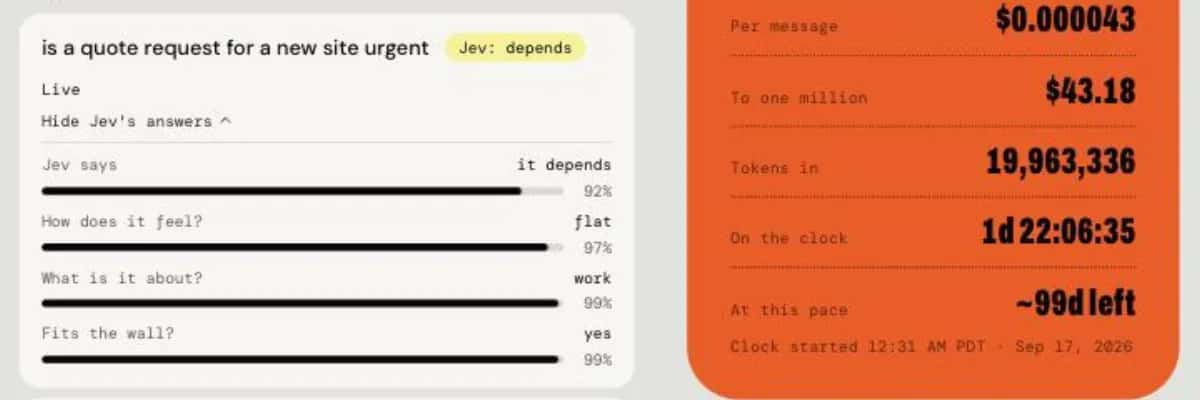
Notre test du 19 septembre 2026 portait sur la question « is a quote request for a new site urgent ». Verdict : « it depends » à 92 %. Les autres champs indiquaient un ton « flat » à 97 % et un sujet « work » à 99 %. La question était jugée recevable à 99 %. Le compteur affichait 18 870 messages traités pour 0,8385 dollar, soit 0,000043 dollar par message.
La veille, le mur de latences de la démo affichait une médiane de 188 millisecondes sur 172 appels. Le 95e centile atteignait 395 millisecondes. Ces valeurs incluent le serveur de la démo. Elles ne constituent pas une mesure de Jev sur Workers AI, mesure que cet article ne prétend pas avoir effectuée.
Ce que le test montre : la réponse est bien une décision structurée avec sa probabilité. Le modèle répond « ça dépend » plutôt que de trancher une question réellement ambiguë. Le mot anglais est imposé par la démo, qui filtre les termes acceptés côté serveur. Ce n’est pas une limite de Jev. Ce qu’il ne montre pas : le comportement sur vos propres questions, en français, avec vos critères.
Les annonces de lancement mettent en avant la vitesse, le prix et l’absence d’hallucination. Ces promesses viennent de l’éditeur. Elles demandent une vérification sur vos propres cas avant toute mise en production.
Ce que ce modèle ne fait pas, de façon factuelle :
Un point mérite d’être répété : « sans hallucination » décrit le respect du cadre, pas la justesse de la décision. Une probabilité mal calibrée sur une option mal décrite reste une erreur silencieuse. La seule parade est un seuil de confiance, une relecture humaine en dessous, et un suivi des cas transmis.
Le travail réel se situe donc dans la formulation des questions, avec les personnes qui connaissent le métier. Enfin, le modèle est récent : tarifs, versions et intégrations peuvent changer vite. Revérifiez la fiche de l’éditeur et celle de Cloudflare avant de lancer un projet.
| 01Il fait | 02Il ne fait pas | 03Conséquence pour vous |
|---|---|---|
| 01Choisir parmi des options déclarées | Inventer une option | Prévoir une option « autre » et suivre sa fréquence |
| 02Donner une probabilité calibrée | Garantir que la décision est juste | Fixer un seuil et une relecture humaine en dessous |
| 03Répondre en quelques centaines de ms (selon l’éditeur) | Rédiger, résumer, converser | Garder un modèle de langage pour les étapes qui écrivent |
| 04Évaluer un état texte ou structuré | Aller chercher une information absente | Vérifier que l’entrée contient ce qu’il faut pour décider |
Choisir parmi des options déclarées
Donner une probabilité calibrée
Répondre en quelques centaines de ms (selon l’éditeur)
Évaluer un état texte ou structuré
Jev est un modèle de décision, pas un modèle de génération de texte. Il répond par un choix, un score ou une probabilité, dans un cadre que vous déclarez, et indique sa confiance. Il est édité par TypeSafe AI et accessible notamment via Cloudflare Workers AI.
Pour une PME qui automatise, son intérêt se situe dans les étapes de tri, de filtrage et de classement d’un workflow. Sa valeur dépend du cadrage des questions et d’un seuil de confiance que vous décidez. Les chiffres de vitesse et de prix sont ceux de l’éditeur au lancement.
Le mot « Jev » est le nom commercial d’aujourd’hui. Ce qui compte pour votre projet est la famille d’outil. Un modèle de décision, appelé par API, renvoie des réponses typées et calibrées. Cette catégorie survivra aux changements de nom et de version.
Pour situer Jev face aux autres modèles d’IA, lisez la comparaison complète des modèles IA. Elle passe en revue les familles de modèles et leurs usages. Le parcours de formation IA de La Refonte travaille, sur deux jours, les garde-fous et les automatisations autour de ce type d’outil.
Dernière mise à jour : 19 septembre 2026
Le parcours IA de La Refonte travaille sur deux jours le prompting, les automatisations no-code, le RAG et les garde-fous, avec vos cas métier.
Pour aller plus loin

Sans engagement, sans jargon
Trente minutes pour identifier ce qui freine votre visibilité et repartir avec les priorités dans le bon ordre.
Discutons de votre projet
30 min · Google Meet
Choisissez le créneau qui vous convient dans notre calendrier. On analyse votre situation avant l’appel pour aller droit au but.
Recherche des créneaux disponibles...