Refonte
Le carnet de La Refonte
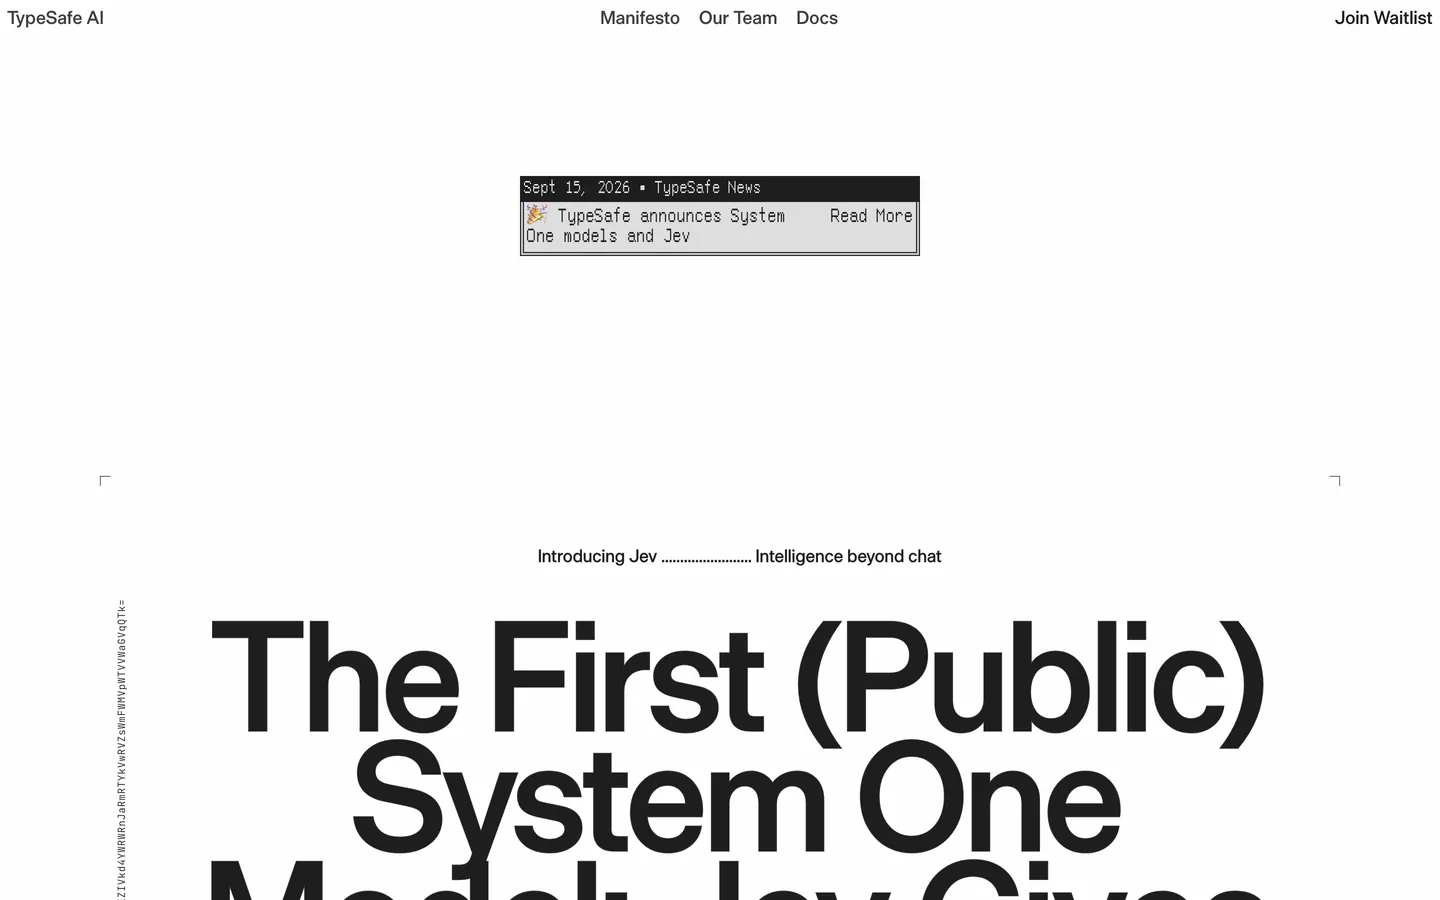
TypeSafe AI, Cloudflare et la documentation de Jev restent silencieux sur la langue. Les bancs d'essai publics sur des modèles multilingues comparables donnent des repères. La Refonte publie un jeu de 30 messages français annotés, une grille et un protocole de mesure, sans inscription.
Refonte
SEO
IA
Jev, le modèle de décision de TypeSafe AI, ne revendique aucune limite de langue : ni sur le site de l'éditeur, ni sur la fiche modèle Cloudflare, ni dans sa documentation technique, où le mot « français » n'apparaît jamais. Le 20 septembre 2026, La Refonte a rejoué sur ce jeu de 30 messages en français, annotés à la main, un protocole de trois passes via l'API OpenRouter : 21 messages sur 30 obtiennent le bon service, 23 sur 30 le bon niveau d'urgence exact et 29 sur 30 à un niveau près, 26 sur 30 le bon ton, avec une médiane de latence de 471 ms. Jev comprend le français des messages clients, fautes et style familier compris ; la qualité du tri dépend d'abord des critères écrits pour chaque catégorie.
TypeSafe AI a annoncé Jev le 15 septembre 2026 comme premier modèle public de sa catégorie « System One ». La presse spécialisée a relayé l'annonce dès le lendemain : The Register a détaillé le profil du fondateur et le financement de 40 millions de dollars, ActuIA a présenté l'approche à ses lecteurs francophones le 18 septembre. Aucun de ces textes n'aborde la question de la langue d'entrée du modèle.
La page d'accueil de l'éditeur, consultée le 20 septembre 2026, ne contient aucune déclaration sur les langues prises en charge. Sa documentation technique, elle aussi rédigée en anglais, décrit les trois types de questions du modèle sans mentionner ni le français ni une quelconque limite linguistique. La fiche du modèle « typesafe/jev » sur Cloudflare Workers AI, classée dans la catégorie « Text Generation » malgré sa nature d'évaluation structurée, se limite à indiquer une fenêtre de contexte de 32 000 tokens et renvoie au tableau de bord pour le tarif. Elle non plus ne dit rien de la langue.
La démonstration publique askjev.ai, elle, ne permet même pas de tester le français : son serveur filtre les messages selon une liste de mots anglais et refuse toute soumission rédigée dans une autre langue, relevé constaté par La Refonte les 18 et 19 septembre 2026. Ce n'est pas une limite de Jev lui-même, puisque la démo n'est pas éditée par TypeSafe AI, mais elle interdit d'observer par ce biais le comportement du modèle sur une entrée française.
Ce silence a une explication technique plausible. Jev évalue un état contre des questions typées : il ne génère pas de texte, donc la notion habituelle de « langue de sortie » d'un modèle génératif ne s'applique pas de la même façon. Reste la question qui compte pour une équipe française : le modèle comprend-il un état et des critères écrits en français aussi bien qu'en anglais ? Aucune des sources consultées n'y répond, ce qui déplace la réponse vers les bancs d'essai publics sur des modèles comparables, puis vers un test mené sur ses propres messages.
| 01Source | 02Ce qu'elle documente | 03Mention de la langue |
|---|---|---|
| 01typesafe.ai (annonce et accueil) | Architecture RLCD, vitesse, prix, absence d'hallucination revendiquée | Aucune mention de langue |
| 02docs.typesafe.ai (documentation technique) | Primitives Choice, Score, Noul, guide de démarrage | Aucune mention de langue, documentation en anglais |
| 03Fiche modèle Cloudflare Workers AI (typesafe/jev) | Catégorie, fenêtre de contexte 32 000 tokens, tarif renvoyé au tableau de bord | Aucune mention de langue |
| 04askjev.ai (démonstration publique, non affiliée) | Interface de test avec 6 questions fixes | Filtre serveur qui refuse les soumissions non anglaises |
typesafe.ai (annonce et accueil)
docs.typesafe.ai (documentation technique)
Fiche modèle Cloudflare Workers AI (typesafe/jev)
askjev.ai (démonstration publique, non affiliée)
À défaut d'une réponse de l'éditeur, la littérature publique sur les grands modèles multilingues donne des repères. Une étude d'octobre 2026 sur la calibration multilingue des grands modèles de langage mesure, sur LLaMA 3 et le test MMMLU, une erreur de calibration (ECE, plus basse est meilleure) de 4,61 % en anglais contre 13,87 % en français, pour une exactitude de 51,30 % en français sur cette tâche. La moyenne toutes langues non anglaises confondues grimpe à 23,12 %. L'écart n'est donc pas propre au français, mais le français n'y échappe pas.
Le même travail teste Aya, un modèle pensé dès le départ pour le multilingue : l'écart s'y resserre nettement, 20,66 % en anglais contre 26,77 % en moyenne non anglaise. Qwen3, entraîné sur un corpus plus équilibré entre les langues, réduit l'écart à 1,56 point seulement. La leçon rejoint celle que documentait déjà, en 2023, un article sur l'iniquité des tokeniseurs entre langues : la performance multilingue d'un modèle dépend directement de la part de chaque langue dans ses données d'entraînement, pas d'une propriété universelle du français ou de l'anglais.
Un second écart, indépendant de la calibration, touche la tokenisation. Une mesure comparant un même passage traduit dans sept langues montre, sur l'encodage o200k de GPT-5, 1,17 token par mot en anglais contre 1,40 en français, soit près de 20 % de tokens en plus pour porter le même sens. L'écart se creuse sur les encodages plus anciens : 110 tokens en anglais contre 194 en français sur l'encodeur cl100k de GPT-4 pour ce même passage, et un rapport comparable mesuré sur Claude Sonnet et Claude Opus.
Pour un modèle de décision comme Jev, facturé au token d'entrée et borné à une fenêtre de contexte fixe, ce n'est pas un détail théorique. Un état en français consomme mécaniquement plus de la fenêtre de 32 000 tokens qu'un état équivalent en anglais, et coûte un peu plus au tarif annoncé de 0,042 dollar par million de tokens en entrée. L'écart reste minoritaire devant la fenêtre disponible pour un message client isolé, mais il grossit avec un état volumineux ou un historique de conversation joint. Notre guide pour déployer Jev sur Cloudflare Workers AI détaille la lecture du seuil de confiance une fois l'appel en place.
Aucun de ces chiffres ne mesure Jev lui-même : ils décrivent des modèles multilingues généralistes et des tokeniseurs GPT ou Claude, pas l'architecture RLCD propre à TypeSafe AI. Ils fixent seulement un ordre de grandeur plausible avant un test direct, et expliquent pourquoi la question de ce dossier ne se limite pas à « répond-il en français » mais porte sur la fiabilité de la décision elle-même.
| 01Modèle | 02ECE anglais | 03ECE français ou non anglais | 04Exactitude français (MMMLU) |
|---|---|---|---|
| 01LLaMA 3 | 4,61 % | 13,87 % (français) / 23,12 % (moyenne non anglaise) | 51,30 % |
| 02Aya (multilingue dès l'origine) | 20,66 % | 26,77 % (moyenne non anglaise) | Non précisé pour le français seul |
| 03Qwen3 (corpus plus équilibré) | Écart anglais/non anglais | 1,56 point d'écart seulement | Non précisé pour le français seul |
LLaMA 3
Aya (multilingue dès l'origine)
Qwen3 (corpus plus équilibré)
Source : Mesure comparant un passage de référence traduit en 7 langues, tiktoken pour GPT-4/GPT-5, endpoint officiel Anthropic pour Claude (2026)
Un message client en français porte des difficultés que les bancs d'essai anglophones ne rencontrent pas dans les mêmes proportions. Les accents et l'orthographe glissent souvent dans un clavier saisi vite : une négation oubliée qui inverse le sens, un mot tronqué, des majuscules qui remplacent la ponctuation pour marquer l'urgence. Le registre change d'un message à l'autre, du vouvoiement formel au tutoiement familier, parfois dans le même échange. Une expression réunionnaise ou créole peut apparaître sans prévenir dans un message envoyé depuis un territoire ultramarin. L'ironie et le sarcasme, difficiles à repérer même pour un lecteur humain pressé, se glissent dans les réclamations. Enfin, un même message mélange souvent plusieurs demandes : une question de facturation suivie d'une remarque sur un retard de livraison.
Un grand modèle de langage génératif absorbe ces variations en les reformulant dans sa réponse, ce qui masque l'ambiguïté plutôt que de la trancher. Un modèle de décision comme Jev fonctionne différemment : il ne reformule rien, il évalue l'état fourni contre des questions déjà typées, avec leurs critères écrits en langage courant. Cette contrainte change la nature du problème. Une faute d'orthographe ou un accent manquant n'empêche pas d'évaluer un critère du type « le message exprime-t-il une urgence » ou « quel service est concerné », tant que le sens général reste lisible. Un message à double demande, lui, reste un vrai piège : le schéma de questions doit prévoir qu'un message porte plusieurs sujets, faute de quoi une seule réponse écrase les autres.
Le vrai levier n'est donc pas la robustesse supposée du modèle aux fautes, sur laquelle aucune source consultée ne s'engage, mais la qualité du cadrage des questions et de leurs critères. Un critère « urgent » décrit en une phrase vague laisse le modèle deviner. Le même critère, décrit avec un exemple positif et un exemple négatif en français courant, réduit la place laissée à l'interprétation, quelle que soit la langue de départ.
// Adaptation illustrative de l'exemple officiel Cloudflare, en français : non testée dans cet article.
const response = await env.AI.run(
  'typesafe/jev',
  {
    state: "Bonjour, ca fait 3 jours que mon virement n'arrive pas, c'est vraiment n'importe quoi !!",
    questions: {
      urgence: {
        type: 'noul',
        instructions: 'Ce message exprime-t-il une urgence ?',
        criteria: { true: "Delai depasse ou mot explicite d'urgence", false: 'Aucune urgence exprimee' },
      },
      service: {
        type: 'choice',
        instructions: 'Quel service doit traiter cette demande ?',
        criteria: {
          facturation: 'Paiements, virements, factures',
          technique: 'Pannes, bugs, integrations',
          commercial: 'Tarifs, nouveaux comptes, devis',
        },
      },
      ton: {
        type: 'score',
        instructions: "Quel est le niveau d'agacement du client ?",
        criteria: ['Calme', 'Agace', 'Tres en colere'],
      },
    },
  },
)
console.log(response)Le tableau qui suit réunit 30 messages rédigés spécifiquement pour ce dossier. Ce ne sont pas des messages clients réels : aucune donnée personnelle n'est en jeu, et aucune anonymisation n'a donc été nécessaire pour les publier. Ils ont été écrits pour couvrir, de façon volontaire, les pièges décrits plus haut : fautes d'orthographe, tutoiement et vouvoiement mélangés, une expression réunionnaise, de l'ironie, des messages à double demande, et quelques messages neutres sans difficulté particulière pour servir de repère.
Chaque message porte trois annotations fixées à l'avance par une lecture humaine, avant tout passage dans un modèle : le service concerné, le niveau d'urgence et le ton. Ces trois annotations forment la vérité de référence à laquelle une décision de Jev pourra être comparée. Le service retenu suit le même découpage que l'exemple officiel de Cloudflare : facturation, technique, commercial, avec une option « autre ». L'urgence et le ton suivent chacun une échelle à trois niveaux, détaillée dans la grille qui suit le tableau.
| 01# | 02Message (rédigé pour le test) | 03Service attendu | 04Urgence attendue | 05Ton attendu |
|---|---|---|---|---|
| 011 | Bonjour, je n'ai pas reçu ma facture du mois dernier, pouvez-vous me la renvoyer svp ? | Facturation | Faible | Calme |
| 022 | ca fait 3 fois que j'ecrit et personne me repond CEST INADMISSIBLE | Autre | Élevée | En colère |
| 033 | Salut, le bouton de paiement bug depuis ce matin, impossible de valider ma commande | Technique | Élevée | Agacé |
| 044 | Bonjour, je voudrais connaître vos tarifs pour un abonnement annuel, merci d'avance | Commercial | Faible | Calme |
| 055 | mon compte a été débité deux fois pour la même commande, il faut rembourser vite | Facturation | Élevée | Agacé |
| 066 | Coucou, petite question, est-ce que vous livrez à La Réunion ? | Commercial | Faible | Calme |
| 077 | Lé la 3 jours mon colis i arrive pa, mi lé pa contan sa | Autre | Moyenne | Agacé |
| 088 | Ah super, encore un bug sur votre site, bravo les ingénieurs | Technique | Moyenne | Agacé |
| 099 | Bonsoir, j'aimerais résilier mon abonnement et être remboursé du mois en cours, et savoir si vous avez une offre étudiante | Commercial | Faible | Calme |
| 1010 | URGENT mon site est down depuis 1h je perds des clients | Technique | Élevée | En colère |
| 1111 | Petite précision sur ma facture d'octobre, rien de grave, quand vous avez 5 minutes | Facturation | Faible | Calme |
| 1212 | tu peux m'dire pourquoi j'ai été facturé deux fois stp | Facturation | Moyenne | Agacé |
| 1313 | Je souhaite passer une commande groupée pour mon entreprise, quel est le délai de livraison ? | Commercial | Faible | Calme |
| 1414 | j'ai contacté 3 fois le support et toujours pas de reponse, je vais changer de prestataire | Autre | Élevée | En colère |
| 1515 | Bonjour, l'application plante à chaque ouverture depuis la mise à jour d'hier | Technique | Moyenne | Agacé |
| 1616 | Merci pour votre réactivité la dernière fois, j'ai juste une question sur le renouvellement | Commercial | Faible | Calme |
| 1717 | g reçu un colis vide, c'est une blague ?? | Autre | Élevée | Agacé |
| 1818 | Bonjour, je n'arrive pas à me connecter à mon espace client depuis ce matin | Technique | Moyenne | Calme |
| 1919 | Franchement, pour le prix, on pourrait s'attendre à un service qui marche | Autre | Moyenne | Agacé |
| 2020 | Est-ce que vous proposez une facture avec TVA pour mon entreprise ? | Facturation | Faible | Calme |
| 2121 | STOP je veux être remboursé MAINTENANT ou je porte plainte | Facturation | Élevée | En colère |
| 2222 | hello, juste pour savoir si le SAV répond aussi le samedi | Autre | Faible | Calme |
| 2323 | je suis obligé de relancer pour la 4e fois, ça commence à faire beaucoup | Autre | Moyenne | Agacé |
| 2424 | Bonjour, j'ai deux questions : la première sur ma commande en retard, la seconde sur un devis pour un second produit | Autre | Moyenne | Calme |
| 2525 | Tout va bien, je voulais juste vous remercier pour la livraison rapide | Autre | Faible | Calme |
| 2626 | g pas reçu le mail de confirmation, c urgent jen ai besoin pour demain | Technique | Élevée | Agacé |
| 2727 | Pouvez-vous m'indiquer comment mettre à jour ma carte bancaire enregistrée ? | Facturation | Faible | Calme |
| 2828 | ça devient n'importe quoi, deuxième panne cette semaine | Technique | Élevée | En colère |
| 2929 | Bonjour, je voulais juste confirmer que ma commande partira bien demain | Autre | Faible | Calme |
| 3030 | Mi lé kontan mais mi trouv sa un pé sher pour sa | Commercial | Faible | Calme |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
La grille fixe, pour chaque message, trois champs à renseigner et leurs valeurs possibles. Le service reprend quatre valeurs : facturation, technique, commercial, autre. L'urgence et le ton suivent chacun une échelle à trois niveaux, décrite dans le tableau ci-dessous avec un critère écrit en français pour chaque valeur, afin que deux personnes différentes annotent le même message de la même façon.
Le taux d'accord se calcule de deux façons complémentaires. Le pourcentage d'accord brut compare, champ par champ, la décision du modèle à l'annotation de référence, et compte la part de messages où les deux coïncident exactement : c'est le calcul utilisé dans les résultats plus bas. Cette mesure simple surestime l'accord quand une valeur domine largement les autres. Le kappa de Cohen corrige ce biais : il compare l'accord observé à l'accord qu'on obtiendrait par un tirage aléatoire respectant la même répartition des valeurs, et renvoie un chiffre entre -1 et 1, où 0 correspond à un accord de pur hasard et 1 à un accord parfait.
Les résultats mesurés le 20 septembre 2026 sur ce jeu de 30 messages sont présentés plus bas, dans la section « Résultats du jeu d'essai ».
| 01Champ | 02Valeur | 03Critère de décision |
|---|---|---|
| 01Urgence | Faible | Aucun délai dépassé, aucun mot d'urgence |
| 02Urgence | Moyenne | Une gêne réelle mais pas de risque immédiat |
| 03Urgence | Élevée | Délai dépassé, perte financière ou mot explicite d'urgence |
| 04Ton | Calme | Formulation neutre ou courtoise, sans marque d'agacement |
| 05Ton | Agacé | Répétition, majuscules partielles, ponctuation appuyée |
| 06Ton | En colère | Menace, mise en demeure, vocabulaire fort |
| 07Service | Facturation | Paiement, remboursement, TVA, moyen de paiement |
| 08Service | Technique | Panne, bug, connexion, intégration |
| 09Service | Commercial | Tarif, offre, nouvelle commande, devis |
| 10Service | Autre | Aucun des trois ci-dessus, ou plusieurs sujets mélangés |
Urgence
Urgence
Urgence
Ton
Ton
Ton
Service
Service
Service
Service
Étape 1
Chaque message du jeu d'essai est soumis trois fois à Jev, pour vérifier si la décision reste stable sur un même état, avant de la comparer à l'annotation humaine.
Étape 2
Les trois réponses sont comparées aux valeurs de la grille, champ par champ, avec le calcul du pourcentage d'accord et du kappa de Cohen décrits plus haut.
Étape 3
En dessous d'un seuil fixé à l'avance, la décision part en relecture humaine plutôt que d'être appliquée automatiquement, quel que soit le champ concerné.
Étape 4
Un message où les trois passes ne s'accordent pas entre elles, ou où le modèle diverge de l'annotation de référence, est consigné avec sa raison probable plutôt qu'écarté.
La Refonte a exécuté ce protocole le 20 septembre 2026, depuis un poste connecté par Starlink, via l'API OpenRouter (endpoint /api/alpha/decisions, modèle typesafe/jev-1.13-20260917) : chaque message du jeu d'essai a été soumis trois fois, soit 90 appels sur les 30 messages. La latence mesurée ici est un aller-retour client complet depuis ce poste, pas la latence serveur, à comparer avec réserve à un relevé mesuré côté serveur.
Taux d'accord sur 30 messages, 3 passes chacun
21/30
Service correct (70 %)
23/30
Urgence exacte (77 %)
29/30
Urgence à un niveau près (97 %)
26/30
Ton correct (87 %)
29/30
Service stable sur les 3 passes (97 %)
Le tableau suivant liste les 9 messages où le service obtenu par Jev diverge du service attendu, avec la confiance renvoyée par le modèle pour sa réponse.
| 01N° | 02Message | 03Service attendu | 04Service obtenu | 05Confiance |
|---|---|---|---|---|
| 017 | Lé la 3 jours mon colis i arrive pa, mi lé pa contan sa | Autre | Technique | 0,22 |
| 029 | Bonsoir, j'aimerais résilier mon abonnement et être remboursé du mois en cours, et savoir si vous avez une offre étudiante | Commercial | Facturation | 0,91 |
| 0314 | j'ai contacté 3 fois le support et toujours pas de reponse, je vais changer de prestataire | Autre | Commercial | 0,27 |
| 0417 | g reçu un colis vide, c'est une blague ?? | Autre | Technique | 0,06 |
| 0519 | Franchement, pour le prix, on pourrait s'attendre à un service qui marche | Autre | Technique | 0,93 |
| 0622 | hello, juste pour savoir si le SAV répond aussi le samedi | Autre | Technique | 0,25 |
| 0724 | Bonjour, j'ai deux questions : la première sur ma commande en retard, la seconde sur un devis pour un second produit | Autre | Commercial | 0,99 |
| 0829 | Bonjour, je voulais juste confirmer que ma commande partira bien demain | Autre | Commercial | 0,93 |
| 0930 | Mi lé kontan mais mi trouv sa un pé sher pour sa | Commercial | Autre | 0,62 |
7
9
14
17
19
22
24
29
30
Aucune des sources officielles consultées, l'éditeur, sa documentation et la fiche modèle Cloudflare, ne prend position sur le français. La mesure du 20 septembre 2026 sur les 30 messages de ce dossier répond directement à la question, sur ce périmètre : Jev traite correctement 21 messages sur 30 pour le service, 23 sur 30 pour l'urgence exacte et 26 sur 30 pour le ton, fautes d'orthographe, tutoiement et une expression réunionnaise compris dans le jeu de test.
La quasi-totalité des erreurs de service, 7 sur 9, concerne la catégorie fourre-tout « autre » : un message de remerciement, une confirmation de commande ou une double question s'y glissent aussi bien qu'une vraie réclamation hors des trois autres services. C'est d'abord un défaut de nos propres critères, la catégorie « autre » n'étant définie que par ce qu'elle n'est pas, pas seulement une limite du modèle : 4 de ces 7 erreurs tombent sous une confiance de 0,3, largement sous un seuil de relecture humaine fixé à 0,7, et sont donc rattrapées avant tout envoi automatique. 3 restent des erreurs confiantes malgré tout, #19, #24 et #29 dans le tableau plus haut : la confiance seule n'y aurait pas suffi, une catégorie « autre » mieux définie par ses propres critères l'aurait probablement évitée.
Le jeu de 30 messages, sa grille d'annotation et le protocole en trois passes, publiés plus haut sans inscription, restent valables pour reprendre ce test sur vos propres catégories de service, avec vos propres critères d'urgence et de ton, en particulier pour écrire une catégorie « autre » qui se définisse positivement plutôt que par défaut.
Une fois le tri fiabilisé sur l'entrée, la question suivante porte sur la sortie : comment vérifier qu'une réponse rédigée par une IA reste correcte avant de partir au client, sujet détaillé dans notre article sur les garde-fous d'une réponse IA. Le tri des demandes entrantes proprement dit, au-delà de ce test, est traité dans notre guide pour trier les demandes d'un formulaire avec l'IA. Le fonctionnement général du modèle reste décrit dans notre article de référence sur Jev, le modèle de décision.
Dernière mise à jour : 20 septembre 2026
Copiez le tableau des 30 messages et la grille d'annotation directement depuis cette page. Pour cadrer un test sur vos propres catégories métier, le parcours IA de La Refonte travaille les questions typées, les automatisations et les garde-fous sur deux jours.
Pour aller plus loin


Sans engagement, sans jargon
Trente minutes pour identifier ce qui freine votre visibilité et repartir avec les priorités dans le bon ordre.
Discutons de votre projet
30 min · Google Meet
Choisissez le créneau qui vous convient dans notre calendrier. On analyse votre situation avant l’appel pour aller droit au but.
Recherche des créneaux disponibles...