Refonte
Le carnet de La Refonte
Une architecture qui fait vérifier une réponse générée par un modèle de décision avant l'envoi : questions typées, seuil de blocage, relecture humaine, et le protocole de test à faire tourner avant la production.
Refonte
IA
SEO
Avant d'envoyer une réponse rédigée par une IA, une architecture de garde-fou pose une question vérifiable par point sensible : la réponse cite-t-elle une source du dossier, reste-t-elle dans le ton attendu, contient-elle une donnée confidentielle. Un modèle de décision comme Jev évalue ces questions et renvoie des probabilités, pas une décision. Le code applique ensuite un seuil : au-dessus, la réponse part ; en dessous, une personne la relit. La Refonte n'a mesuré aucun taux de blocage sur ce montage : elle propose ici le protocole de test à faire tourner avant toute mise en production.
Un modèle de langage rédige une réponse fluide, bien construite, avec un ton assuré. Cette qualité d'écriture ne dit rien de son exactitude. Le texte peut citer un chiffre absent du dossier, répondre à côté de la demande, adopter un registre décalé pour le destinataire, ou reprendre une information confidentielle qui n'aurait pas dû sortir du dossier interne. Rien dans la fluidité du texte ne signale ces erreurs.
Une entreprise qui a déjà automatisé la rédaction, par exemple avec un assistant IA qui répond à partir d'un dossier ou un agent qui prépare une fiche produit, affronte ce problème à chaque envoi. Notre article sur les garde-fous d'un agent IA en entreprise pose le principe général : validation humaine sur tout envoi, journal des décisions, seuils explicites. Ce tutoriel détaille comment un modèle de décision comme Jev automatise une partie de cette relecture, sans remplacer la personne qui tranche les cas ambigus.
Le problème s'aggrave avec le volume. Une personne qui relit dix réponses par jour repère plus facilement une anomalie qu'une équipe qui en produit plusieurs centaines, tous les jours, sur des canaux différents. Un garde-fou automatisé ne supprime pas la relecture humaine : il la concentre sur les cas qui en ont vraiment besoin, et laisse partir les autres sans intervention.
La suite pose une architecture précise : quatre points de contrôle transformés en questions vérifiables, un modèle qui les évalue, un seuil qui décide d'envoyer ou de transmettre, et un protocole pour tester ce montage avant de lui faire confiance.
Avant l'envoi, une relecture humaine porte en général sur quatre points : l'exactitude des faits cités, la cohérence avec la demande initiale, le ton adapté au destinataire, l'absence de donnée confidentielle. Une architecture de garde-fou reprend ces quatre points, mais les reformule en questions que le modèle de décision peut évaluer sans ambiguïté.
Une question mal posée renvoie une probabilité mal calibrée. « La réponse est-elle correcte ? » ne se vérifie pas : correcte selon quel critère ? « Chaque chiffre cité dans la réponse figure-t-il dans le dossier fourni ? » se vérifie. Le travail de cadrage porte sur cette reformulation, avec les personnes qui connaissent le métier, avant d'écrire la moindre ligne de code.
Ces quatre points ne sont pas exhaustifs. Un cabinet qui répond à des demandes réglementées peut ajouter un cinquième point sur la présence d'un avertissement obligatoire. Un service commercial peut ajouter un point sur les prix annoncés, pour vérifier qu'ils correspondent bien au tarif en vigueur. Le principe reste le même : chaque point de contrôle devient une question à laquelle le modèle peut répondre par une probabilité, pas par une appréciation générale.
Le tableau ci-dessous reprend les quatre points, le type de question qui leur correspond et un exemple de critère.
| 01Point de contrôle | 02Type de question | 03Exemple de critère posé au modèle |
|---|---|---|
| 01Exactitude des faits | Noul | Chaque chiffre ou fait cité figure-t-il dans le dossier fourni ? |
| 02Cohérence avec la demande | Choice | La réponse traite-t-elle la demande initiale, une autre demande, ou aucune des deux ? |
| 03Ton et registre | Score | Registre du texte, de neutre professionnel à familier |
| 04Confidentialité | Noul | La réponse contient-elle une donnée personnelle ou confidentielle absente du dossier ? |
Exactitude des faits
Cohérence avec la demande
Ton et registre
Confidentialité
Chez Jev, le modèle de décision de TypeSafe AI disponible sur Cloudflare Workers AI sous l'identifiant « typesafe/jev », chaque question déclare un type, une instruction et des critères. Selon la fiche modèle consultée le 20 septembre 2026, une question de type Noul renvoie une probabilité entre 0 et 1 sur un critère fermé ; une question Choice renvoie l'option retenue parmi une liste que vous décrivez, avec la probabilité de chaque option ; une question Score place la réponse sur une échelle que vous définissez. L'exemple publié par Cloudflare porte sur l'urgence d'un message : une question Noul demande si le texte « convey urgency », avec les critères vrai et faux explicités en une phrase chacun.
L'état soumis au modèle, le paramètre state, peut être un texte simple ou un objet structuré : ici, la réponse générée par le premier modèle, accompagnée du dossier ou de la demande initiale qui a servi à la rédiger. Sans ce dossier en entrée, une question comme « cite-t-elle une source du dossier ? », le deuxième cas d'usage décrit dans notre article sur le modèle de décision Jev, n'a rien à vérifier.
Le champ criteria mérite une attention particulière. Pour une question Noul, il décrit en une phrase ce qui vaut vrai et ce qui vaut faux. Pour une question Choice, chaque option porte sa propre description. Pour une question Score, les deux bornes de l'échelle sont décrites, et le modèle situe la réponse entre elles. Une probabilité mal calibrée vient presque toujours d'un critère ambigu à ce niveau, pas d'une limite du modèle lui-même : reformuler le critère règle plus souvent le problème que changer de modèle.
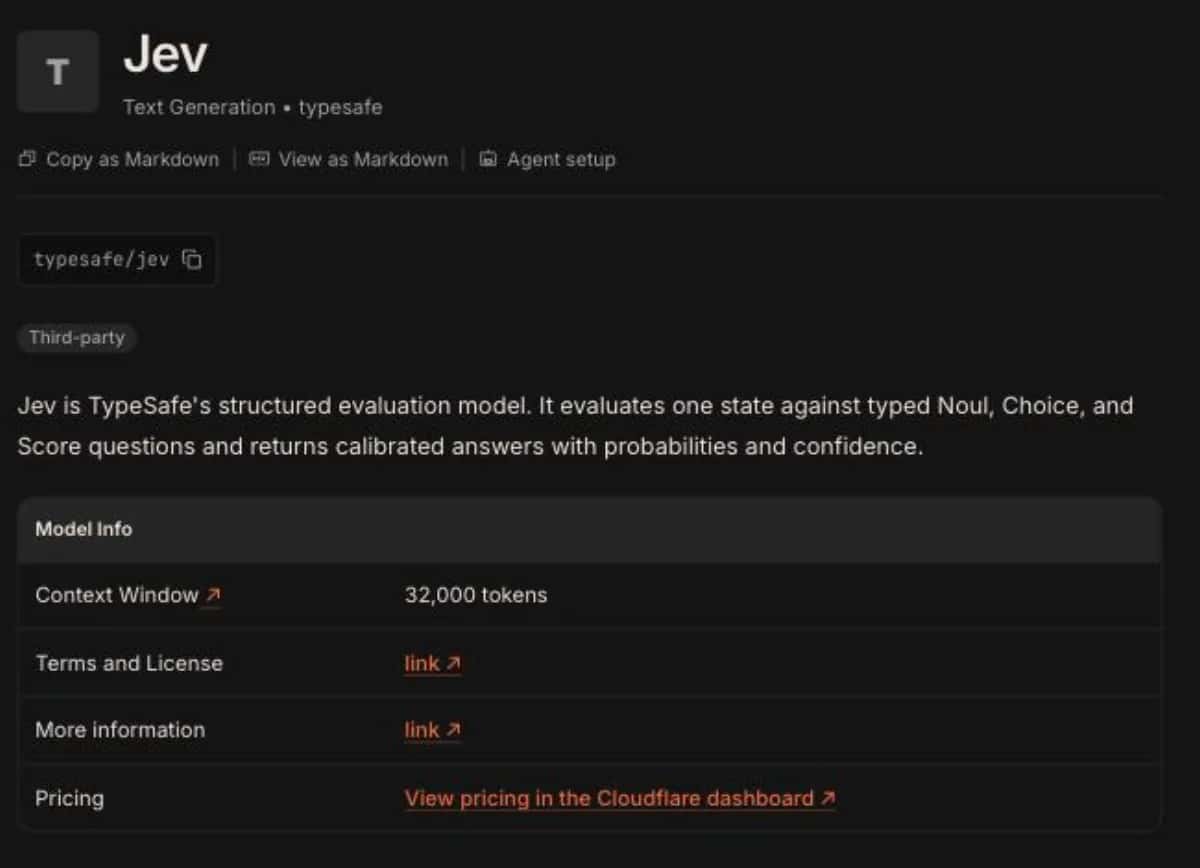
Le garde-fou s'intercale entre la génération et l'envoi, jamais avant. Une fois que le premier modèle a produit sa réponse, le code assemble un état : le texte généré, la demande initiale, et le dossier ou les documents qui ont servi de matière. Il déclare ensuite les questions typées définies plus haut, une par point de contrôle.
L'appel qui suit reprend la structure décrite par Cloudflare pour typesafe/jev : un champ state et un champ questions, chacune avec son type, ses instructions et ses critères. Les noms de questions (facts_grounded, on_topic, tone, has_sensitive_data) sont une convention de ce tutoriel, pas une exigence du modèle : c'est une proposition de La Refonte, à adapter à vos propres champs.
Le modèle de décision est, comme le premier modèle, un service tiers. La réponse envoyée en vérification peut porter les mêmes informations sensibles que le dossier d'origine. N'envoyez que ce qui sert la décision : un résumé du dossier ou un identifiant que votre propre code résout suffit parfois, à la place du document complet. Vérifiez les conditions d'utilisation du modèle avant d'y faire transiter une donnée personnelle.
const draft = await generateReply(ticket) // le premier modèle a déjà répondu

const verif = await env.AI.run('@cf/typesafe/jev', {
  state: {
    reponse_generee: draft.text,
    demande_initiale: ticket.message,
    dossier_source: ticket.contextDocs,
  },
  questions: {
    facts_grounded: {
      type: 'noul',
      instructions: 'Chaque fait ou chiffre de la réponse figure-t-il dans le dossier source ?',
      criteria: {
        true: 'Tous les faits cités proviennent du dossier',
        false: 'Au moins un fait ne provient pas du dossier',
      },
    },
    on_topic: {
      type: 'choice',
      instructions: 'La réponse traite-t-elle la demande initiale ?',
      criteria: {
        on_topic: 'Répond à la demande',
        off_topic: 'Répond à une autre demande',
        mixed: 'Répond partiellement à la demande',
      },
    },
    tone: {
      type: 'score',
      instructions: 'Registre du texte pour un client professionnel',
      criteria: { 1: 'Neutre professionnel', 5: 'Familier ou inapproprié' },
    },
    has_sensitive_data: {
      type: 'noul',
      instructions: 'La réponse contient-elle une donnée personnelle ou confidentielle absente du dossier source ?',
      criteria: {
        true: 'Donnée sensible détectée hors dossier',
        false: 'Aucune donnée sensible hors dossier',
      },
    },
  },
})Le modèle renvoie une probabilité par question, et une confiance pour les questions Choice et Score. Ces chiffres ne sont pas une décision : ils indiquent à quel point le modèle est sûr de son évaluation. La règle de blocage se code séparément, avec un seuil que vous choisissez.
Le seuil dépend du coût d'une erreur qui passerait. Laisser filer un ton trop familier vers un client habitué se corrige d'un mot d'excuse. Laisser filer une donnée confidentielle ne se corrige pas. Un même garde-fou peut donc appliquer un seuil différent par question : plus strict sur la confidentialité, plus permissif sur le ton. En dessous du seuil sur n'importe quelle question, la réponse part en relecture humaine, avec les probabilités jointes pour accélérer l'arbitrage. Les valeurs de l'extrait ci-dessous sont illustratives : elles n'ont pas été mesurées par La Refonte et se recalibrent sur vos propres cas, selon le protocole présenté plus bas.
Chaque vérification appelle le modèle de décision, donc a un coût et une latence, même faibles pris isolément. Sur un flux à fort volume, ce coût s'additionne : mesurez-le sur votre propre volume avant de généraliser le garde-fou à toutes les réponses générées. Le journal de ces décisions n'est pas un détail annexe : c'est lui qui permet, plusieurs semaines après la mise en service, de revenir sur un seuil mal calibré avec des cas concrets plutôt qu'avec une impression.
const { facts_grounded, on_topic, tone, has_sensitive_data } = verif.answers

const bloque =
  facts_grounded.false > 0.15 ||
  has_sensitive_data.true > 0.05 ||
  on_topic.choice !== 'on_topic' ||
  tone.score >= 4

if (bloque) {
  await sendToHumanReview({ draft, answers: verif.answers })
} else {
  await sendReply(draft)
}Les trois cas suivants sont des illustrations pédagogiques construites pour ce tutoriel, pas des échanges clients réels. Ils montrent comment une question typée repère un problème que la fluidité du texte cache, sur trois tâches courantes en petite entreprise : une réponse à un client, une fiche produit, un compte rendu de réunion.
Dans chaque cas, la réponse générée est plausible à la lecture. C'est précisément ce qu'une relecture humaine seule finit parfois par laisser passer, sur un volume élevé de textes à valider chaque jour. Ces trois illustrations ne couvrent pas systématiquement les quatre points de contrôle : elles montrent la mécanique du garde-fou, pas un test exhaustif de ses capacités.
| 01Tâche (illustration) | 02Ce que la réponse générée affirme | 03Question typée qui la repère | 04Décision du garde-fou |
|---|---|---|---|
| 01Réponse à un client | Annonce un délai de livraison de 48 heures alors que le dossier fourni indique 5 jours ouvrés | facts_grounded (Noul) : chaque fait cité figure-t-il dans le dossier ? | Probabilité de fait non fondé élevée : réponse bloquée, transmise en relecture avec l'écart signalé |
| 02Fiche produit | Reprend un registre familier sur une fiche destinée à un catalogue B2B | tone (Score) : registre du texte | Score au-dessus du seuil de familiarité fixé pour ce catalogue : réponse bloquée |
| 03Compte rendu de réunion | Mentionne le nom d'un client tiers cité en exemple pendant la réunion, absent du document destiné à circuler | has_sensitive_data (Noul) : donnée absente du dossier source ? | Probabilité de donnée hors dossier élevée : compte rendu bloqué avant diffusion |
Réponse à un client
Fiche produit
Compte rendu de réunion
Une question revient souvent, sans lien direct avec l'architecture décrite ici : comment reconnaître un texte généré par une IA en le lisant ? Aucune méthode de lecture n'est fiable à 100 %. Des signaux de style existent, comme des généralités sans détail vécu ou des structures répétées d'un paragraphe à l'autre, mais aucun ne prouve seul l'origine d'un texte.
Le garde-fou de ce tutoriel répond à une autre question, plus étroite et vérifiable : cette réponse précise, déjà identifiée comme générée par votre propre outil, respecte-t-elle les critères que vous avez fixés ? La relecture d'une réponse IA avant envoi ne consiste pas à deviner son origine, mais à vérifier son contenu contre un dossier et des règles connues. Confondre les deux questions conduit à chercher un détecteur universel là où une procédure de vérification ciblée, propre à votre activité, suffit.
La liste qui suit reprend l'ordre pratique pour cadrer ce garde-fou dans votre organisation, avant d'écrire la première ligne de code de production. Chaque étape implique les personnes qui connaissent le métier, pas seulement l'équipe technique.
Désignez aussi une personne responsable du garde-fou une fois en service. Elle reçoit les cas transmis en relecture, ajuste le seuil au fil des semaines et décide d'élargir ou de restreindre les points de contrôle. Sans ce rôle, le seuil se fige au réglage du premier jour, alors même que les cas transmis en relecture contiennent l'information nécessaire pour l'affiner.
Étape 1
Reprenez les quatre catégories usuelles (faits, cohérence, ton, confidentialité) et ajoutez celles propres à votre activité. N'en gardez que celles qui changeraient une décision d'envoi.
Étape 2
Pour chaque point, choisissez Noul, Choice ou Score et rédigez l'instruction et les critères avec la personne qui relit aujourd'hui ces textes.
Étape 3
Une question comme « cite-t-elle une source du dossier ? » suppose un dossier bien délimité en entrée. Sans lui, la question n'a rien à vérifier.
Étape 4
Partez haut, surtout sur les points coûteux à manquer. Le seuil se resserre ensuite au fil des cas transmis, jamais l'inverse au départ.
Étape 5
Chaque envoi automatique et chaque transmission en relecture doit rester traçable, pour ajuster le seuil sur des cas réels.
Étape 6
Suivez le protocole de test présenté plus haut sur des réponses déjà validées, avant de laisser le garde-fou décider seul.
Ce modèle ne remplace pas un fichier à télécharger : c'est une structure à copier et à adapter avec votre équipe, question par question. Il reprend les quatre champs qui reviennent dans chaque question typée déclarée à un modèle de décision : le rôle attendu de la réponse vérifiée, la matière fournie en entrée, le format de sortie attendu, et le critère qui déclenche un refus.
Remplissez ce modèle en atelier avec les personnes qui relisent aujourd'hui ces textes à la main. Elles connaissent déjà, souvent sans les avoir formalisés, les critères qui font qu'une réponse part ou reste bloquée. Rédiger l'instruction et les critères de chaque question suit la même discipline que la rédaction d'une consigne pour un modèle de langage, détaillée dans notre article sur le prompt IA en entreprise.
question: nom_court_de_la_question
role_de_la_reponse_verifiee: >
  Ce que la réponse générée est censée faire
  (répondre au client, décrire le produit, résumer la réunion...)
matiere_fournie_en_entree:
  - Le texte généré à vérifier
  - Le dossier ou la demande initiale qui sert de référence
type_de_question: noul  # ou choice, ou score
criteres_de_reponse:
  - "Décrire en une phrase le cas qui vaut vrai, une option, ou le haut de l'échelle"
  - "Décrire en une phrase le cas qui vaut faux, une autre option, ou le bas de l'échelle"
critere_de_refus:
  seuil: "Valeur à partir de laquelle le cas part en relecture humaine"
action: "Relecture humaine avec les probabilités jointes, jamais un envoi silencieux"Ce garde-fou ne traite qu'une partie de ce qu'une entreprise délègue à l'IA. Notre guide sur l'automatisation des tâches distingue ce qui peut être confié à une machine de ce qui doit rester sous décision humaine, au-delà de la seule vérification avant envoi. Le fonctionnement détaillé d'un modèle de décision comme Jev, ses trois types de questions et ses limites, est décrit dans notre article sur le modèle de décision Jev. Le cadre réglementaire compte aussi : notre article sur l'AI Act en entreprise détaille les obligations de transparence qui peuvent s'appliquer à un système qui influence, même partiellement, une décision d'envoi.
Dernière mise à jour : 20 septembre 2026
La Refonte accompagne les équipes qui veulent brancher un modèle de décision sur une automatisation existante, avec des questions cadrées, un seuil et une relecture humaine.
Pour aller plus loin

Sans engagement, sans jargon
Trente minutes pour identifier ce qui freine votre visibilité et repartir avec les priorités dans le bon ordre.
Discutons de votre projet
30 min · Google Meet
Choisissez le créneau qui vous convient dans notre calendrier. On analyse votre situation avant l’appel pour aller droit au but.
Recherche des créneaux disponibles...