Refonte
Le carnet de La Refonte
System one model : une catégorie d’IA qui décide au lieu de rédiger. Origine Kahneman, différence avec un LLM, usages plausibles et limites documentées.
Refonte
SEO
IA
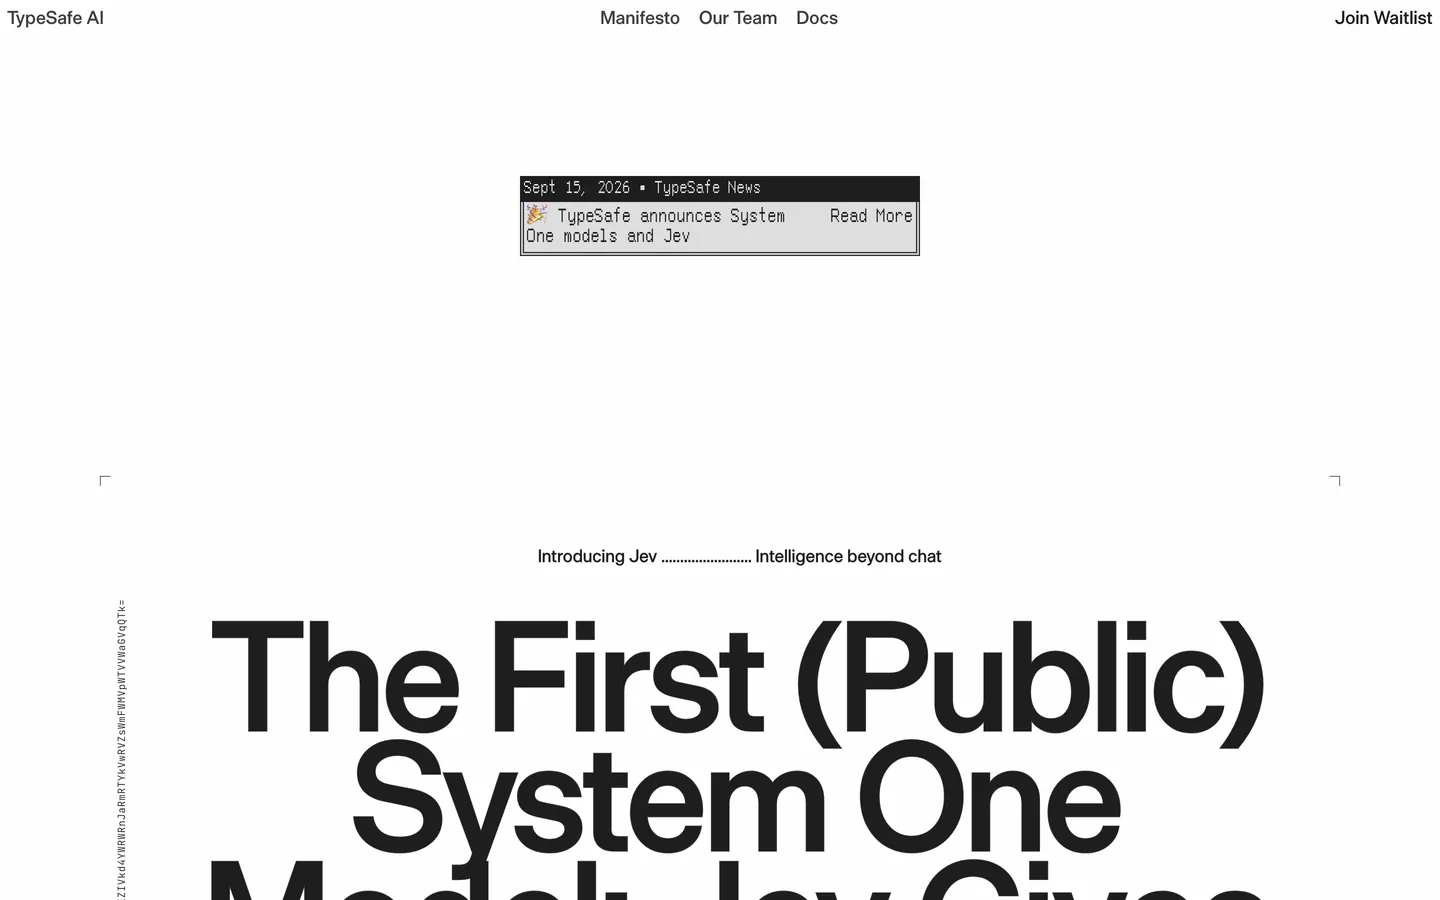
Un system one model est une catégorie d’intelligence artificielle qui rend une décision typée, une probabilité, une note ou un choix, plutôt que de générer un texte libre. C’est l’opposé d’un modèle de langage conversationnel, pensé pour rédiger ou converser. TypeSafe AI a présenté Jev, le 15 septembre 2026, comme le premier system one model accessible publiquement. Cette catégorie sert à automatiser des décisions fermées et répétitives, comme trier ou classer une demande, pas à écrire à la place d’une personne.
Un system one model est une catégorie de modèle d’intelligence artificielle conçue pour rendre une décision typée plutôt que pour générer un texte. La sortie est un choix parmi des options que vous avez décrites, une note sur une échelle, ou une probabilité comprise entre 0 et 1. Elle n’est jamais une phrase rédigée pour un lecteur humain.
TypeSafe AI, une jeune entreprise fondée par Diogo Almeida, ancien chercheur d’OpenAI, appuyée par une levée de fonds de 40 millions de dollars menée par DCVC, a présenté cette catégorie et son premier modèle public, Jev, le 15 septembre 2026. La presse spécialisée a relayé l’annonce dès le lendemain. Jev illustre la catégorie ; il n’en est pas la seule incarnation possible, ni la définition elle-même.
Le principe tient en deux temps. Vous déclarez d’abord des questions et leurs valeurs possibles, en langage courant. Le modèle évalue ensuite une situation, un message ou un dossier, contre ces questions, et renvoie une réponse dans le cadre que vous avez fixé, jamais hors de cette liste.
Un système d’intelligence artificielle, au sens large, désigne tout dispositif logiciel qui traite des données pour produire une sortie utile : reconnaissance d’image, recommandation, génération de texte, ou décision. Un system one model est un cas particulier de cette famille plus vaste, spécialisé dans la décision typée. Il ne remplace pas la définition générale d’un système d’IA, il en précise un usage.
Le terme « system one model » n’est pas, à ce jour, un standard reconnu par l’ensemble du secteur. Il est employé, au moment de la rédaction, par TypeSafe AI pour désigner sa propre catégorie. D’autres éditeurs pourraient choisir un nom différent pour une approche comparable, sans changer la nature de la sortie décrite plus haut.
À retenir : la sortie est typée, exploitable directement par du code : un choix, un score ou une probabilité. C’est cette forme de sortie qui définit la catégorie, avant même le nom d’un éditeur ou d’un modèle particulier.
L’expression vient des travaux du psychologue Daniel Kahneman sur le raisonnement humain, popularisés dans son livre « Système 1 / Système 2 ». Il distingue un système 1, rapide et automatique, d’un système 2, lent et délibéré. Cette distinction appartient à la psychologie ; elle n’a été inventée par aucun éditeur de logiciel.
TypeSafe AI reprend ce vocabulaire pour nommer sa catégorie de modèles. L’idée : un modèle « System One » rend une décision rapide et bornée, un peu comme un réflexe entraîné. Un grand modèle de langage se rapproche davantage d’un raisonnement plus ouvert, construit étape par étape, plus proche d’un système 2 dans cette analogie.
Cette analogie a une conséquence concrète sur la sortie du modèle. Un system one model ne délibère pas devant vous : il compare directement un état à des critères déclarés, et répond en une fois. Un grand modèle de langage écrit sa réponse mot après mot, ce qui laisse place à une génération plus longue, mais aussi plus libre.
Les classifications des modèles d’IA varient selon les auteurs. On croise le plus souvent une famille générative (texte, image, son), une famille prédictive plus ancienne (classification, scoring), les agents qui enchaînent plusieurs étapes, et cette catégorie plus récente de décision typée. Aucune de ces listes n’est une norme officielle ; elles servent surtout à s’orienter.
Cette distinction sert avant tout à nommer une nouvelle génération de modèles orientés décision. Elle ne prétend pas classer rigoureusement tous les modèles d’IA existants dans deux cases. Un classificateur prédictif plus ancien partage déjà certains traits avec cette catégorie, sans porter ce nom ni cette architecture. Le point commun de toutes ces catégories reste le même : savoir ce que la sortie d’un modèle donné peut, ou ne peut pas, faire à votre place.
| 01Logique de raisonnement | 02Ce qu’elle décrit chez un humain (Kahneman) | 03Ce qu’elle inspire côté modèle d’IA |
|---|---|---|
| 01Système 1 : rapide, automatique | Une réaction immédiate, peu d’effort conscient | Un system one model : décision typée rendue en un appel |
| 02Système 2 : lent, délibéré | Un raisonnement construit, étape par étape | Un grand modèle de langage : texte généré mot après mot |
Système 1 : rapide, automatique
Système 2 : lent, délibéré
Un grand modèle de langage (LLM) génère du texte mot après mot, à partir d’un prompt libre. Il peut produire un paragraphe, du code, ou du JSON informel. Rien ne l’empêche techniquement de s’écarter du format attendu : c’est le mécanisme d’une hallucination.
Un system one model comme Jev fonctionne différemment. Vous déclarez d’abord des questions typées, avec leurs valeurs possibles. Le modèle évalue ensuite un « état » (un message, un dossier, une commande) contre ces questions et renvoie une réponse dans le cadre fixé, jamais hors de la liste que vous avez décrite.
Sur le plan technique, TypeSafe AI nomme son architecture RLCD, pour « Reinforcement Learning for Calibrated Decisions ». Elle ne prédit pas les tokens un par un comme un LLM ; elle renvoie toutes les réponses en une fois, avec une probabilité calibrée pour chacune. C’est ce mécanisme qui permettrait, selon l’éditeur, de rester dans le cadre déclaré.
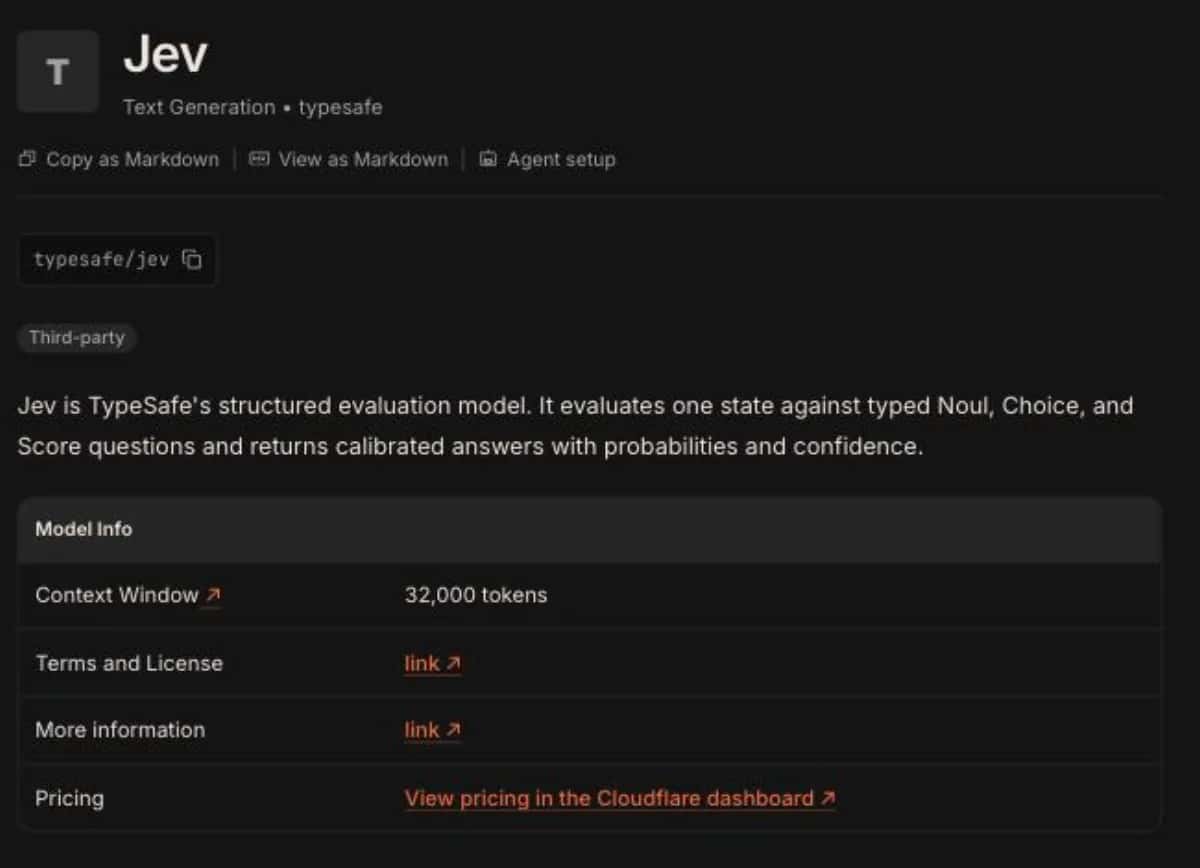
Sur Cloudflare Workers AI, qui héberge Jev sous l’identifiant « typesafe/jev », la fiche modèle le classe pourtant dans la catégorie « Text Generation », au même titre qu’un LLM. C’est un signe que les catégories d’aujourd’hui n’ont pas encore de case dédiée pour ce type de sortie. Sortie typée : un choix, une note ou une probabilité, plutôt qu’un texte. La fenêtre de contexte annoncée est de 32 000 tokens, un chiffre proche de celui de nombreux LLM.
La fiche Cloudflare propose trois façons d’appeler le modèle : en TypeScript avec le kit officiel, en requête REST directe, ou par un exemple JSON complet. Trois cas d’usage y sont détaillés : évaluer une demande de remboursement, orienter un message vers le bon service, ou estimer un risque sur un compte. Ce sont des exemples documentés, pas des mesures de La Refonte.
« Sans hallucination » mérite une précision. Le terme décrit ici le respect strict du format et des valeurs déclarées, pas la justesse de fond de la décision. Un modèle qui reste dans le cadre peut encore se tromper sur le fond, en attribuant par exemple la mauvaise urgence à un message pourtant bien classé dans une catégorie existante.
La proximité avec un LLM s’arrête là. Un modèle de langage reste indispensable pour rédiger, résumer ou tenir une conversation. Un system one model n’écrit pas : il compare et il note. Notre comparaison modèle de décision ou LLM détaille comment choisir entre les deux pour une tâche donnée.
| 01Critère | 02Modèle de langage (LLM) | 03System one model (ex. Jev) |
|---|---|---|
| 01Sortie | Texte libre, généré mot après mot | Sortie typée : un choix, une note ou une probabilité |
| 02Ce que vous fournissez | Un prompt ouvert | Un état à évaluer et des questions typées avec leurs valeurs possibles |
| 03Cas d’usage typique | Rédiger, résumer, converser | Trier, classer, prioriser une demande |
| 04Risque documenté | Hallucination : une réponse hors sujet ou inventée | Erreur dans le cadre : une probabilité mal calibrée sur la bonne option |
Sortie
Ce que vous fournissez
Cas d’usage typique
Risque documenté
Les usages plausibles évoqués par l’éditeur restent proches d’un besoin classique d’automatisation : trier un message entrant, orienter une demande vers le bon service, ou noter le niveau d’urgence d’un dossier. Ce sont des décisions fermées, répétées, et réversibles en cas d’erreur.
L’annonce de TypeSafe AI revendique une absence d’hallucination et des réponses nettement plus rapides et moins coûteuses qu’un grand modèle de langage sur ce type de tâche, avec un chiffre affiché de « 193,6 fois plus rapide, 444,6 fois moins cher ». Ce chiffre vient de l’éditeur, à la date de son lancement : La Refonte ne l’a pas mesuré elle-même.
La même documentation reconnaît, dans sa propre foire aux questions, que le modèle « peut encore se tromper ». Le média spécialisé ActuIA, le 18 septembre 2026, précise le type d’erreurs documenté par l’éditeur : une interprétation trop littérale, des difficultés de calcul, des erreurs de comparaison de dates, et une fiabilité réduite quand le contexte fourni contient des détails hors sujet.
L’éditeur ajoute une nuance rarement mise en avant dans les annonces de lancement : une formulation adverse d’une question peut influencer la réponse, même dans ce cadre borné. Respecter le format attendu ne protège donc pas complètement contre une manipulation de l’entrée. C’est un argument de plus pour garder un seuil de confiance et un contrôle humain sur les cas sensibles.
« Sans hallucination », dans ce contexte, décrit le respect du format attendu, pas la justesse de la décision. TypeSafe AI le précise elle-même : une confiance calibrée aide à repérer les cas incertains, elle n’assure pas une réponse juste. Ce cadrage rejoint celui déjà posé pour Jev dans notre article sur le modèle.
Concrètement, ces réserves ne disqualifient pas la catégorie : elles en précisent le mode d’emploi. Un cas où le contexte est chargé de détails hors sujet, ou une date à comparer, mérite une relecture plutôt qu’une confiance automatique. C’est le même principe de seuil déjà recommandé pour Jev dans notre article de référence.
Une TPE ou une PME qui automatise un processus n’a pas toujours besoin d’un modèle qui écrit à sa place. Elle a souvent besoin d’un tri fiable dans un flux : des e-mails entrants, des devis à qualifier, des avis clients à classer par urgence.
Comprendre qu’il existe une catégorie de modèles pensée pour une décision automatisée, distincte d’un assistant conversationnel, aide à cadrer un projet avant de choisir un outil. La question à poser n’est pas « quel LLM choisir », mais « ai-je besoin d’un texte rédigé, ou d’une décision typée exploitable par du code ? ».
Prenez l’exemple d’une boîte e-mail de support partagée entre plusieurs personnes. Un modèle de cette catégorie peut évaluer chaque message reçu et répondre par un service concerné, un niveau d’urgence, et une confiance. Le code applique ensuite un seuil : au-dessus, il route automatiquement ; en dessous, une personne relit.
Avant de choisir un outil de cette catégorie, il est utile de lister les décisions déjà prises manuellement dans l’entreprise : quel service traite telle demande, quel dossier est prioritaire, quel client rappeler d’abord. Ces règles existantes servent de point de départ pour décrire les questions et leurs critères à un system one model.
Cette réflexion s’inscrit dans une démarche plus large de cadrage d’automatisation, détaillée dans notre guide sur l’automatisation des tâches. Elle rejoint aussi les garde-fous décrits pour un agent IA en entreprise : seuil, journal des décisions, et relecture humaine.
Le nom du modèle importe moins que la catégorie. Jev est la marque d’aujourd’hui ; d’autres éditeurs présenteront probablement des system one models sous d’autres noms. Ce qui reste utile pour votre entreprise, c’est de savoir reconnaître cette forme de sortie avant de choisir un outil, quel que soit le nom sur l’étiquette.
Dernière mise à jour : 20 septembre 2026
Jev n’est qu’un nom, aujourd’hui. La catégorie des system one models va probablement s’étoffer avec d’autres éditeurs. Lisez notre veille sur les nouveaux modèles IA pour suivre ce qui compte, au-delà d’une annonce.
Pour aller plus loin


Sans engagement, sans jargon
Trente minutes pour identifier ce qui freine votre visibilité et repartir avec les priorités dans le bon ordre.
Discutons de votre projet
30 min · Google Meet
Choisissez le créneau qui vous convient dans notre calendrier. On analyse votre situation avant l’appel pour aller droit au but.
Recherche des créneaux disponibles...