Refonte
Le carnet de La Refonte
Le dossier des mesures publiées sur Jev, le modèle de décision de TypeSafe AI, exécuté sur Cloudflare Workers AI : latence, coût, précision, et le code pour les reproduire depuis votre propre Worker.
Refonte
WordPress
SEO
Jev, le modèle de décision de TypeSafe AI, s'appelle depuis un Worker Cloudflare sous l'identifiant « typesafe/jev », avec un contexte de 32 000 tokens. L'éditeur annonce 0,042 $ par million de tokens en entrée, sortie gratuite, pour une latence de 70 à 500 millisecondes. Les relevés publics le confirment dans cet ordre de grandeur, et La Refonte a désormais ses propres chiffres : le 20 septembre 2026, un protocole de 6 cas-tests et 5 passes a été rejoué via l'API OpenRouter, avec une médiane de 497 ms et un coût de 0,0000217 $ par appel. Ce dossier réunit ces mesures, sourcées et datées, avant le protocole pour les reproduire depuis votre propre Worker.
Ce dossier mesure ce qui est publiquement observable quand Jev tourne sur Cloudflare Workers AI : la latence perçue par l'appelant, le format des probabilités renvoyées et le comportement réel sur des cas concrets, à partir de sources tierces datées. Il ne mesure pas la justesse sur du français ni sur votre jargon métier, ni la latence depuis votre propre réseau : ces deux points restent à tester chez vous, avec vos messages.
Trois familles de sources composent ce dossier : les chiffres publiés par l'éditeur TypeSafe AI et par Cloudflare, la démo publique askjev.ai, observée depuis le 18 septembre 2026, et des bancs d'essai tiers indépendants de l'éditeur, qui comparent Jev à des modèles de langage répondant en JSON sur des tâches de classification comparables. Chaque chiffre cité porte sa source et sa date, listées en fin de page. Ce dossier se distingue volontairement du guide d'implémentation : il ne réexplique pas le binding ni les trois types de questions, déjà détaillés ailleurs sur ce blog, mais réunit ce qu'on peut savoir de la vitesse et du coût de Jev avant de s'y engager.
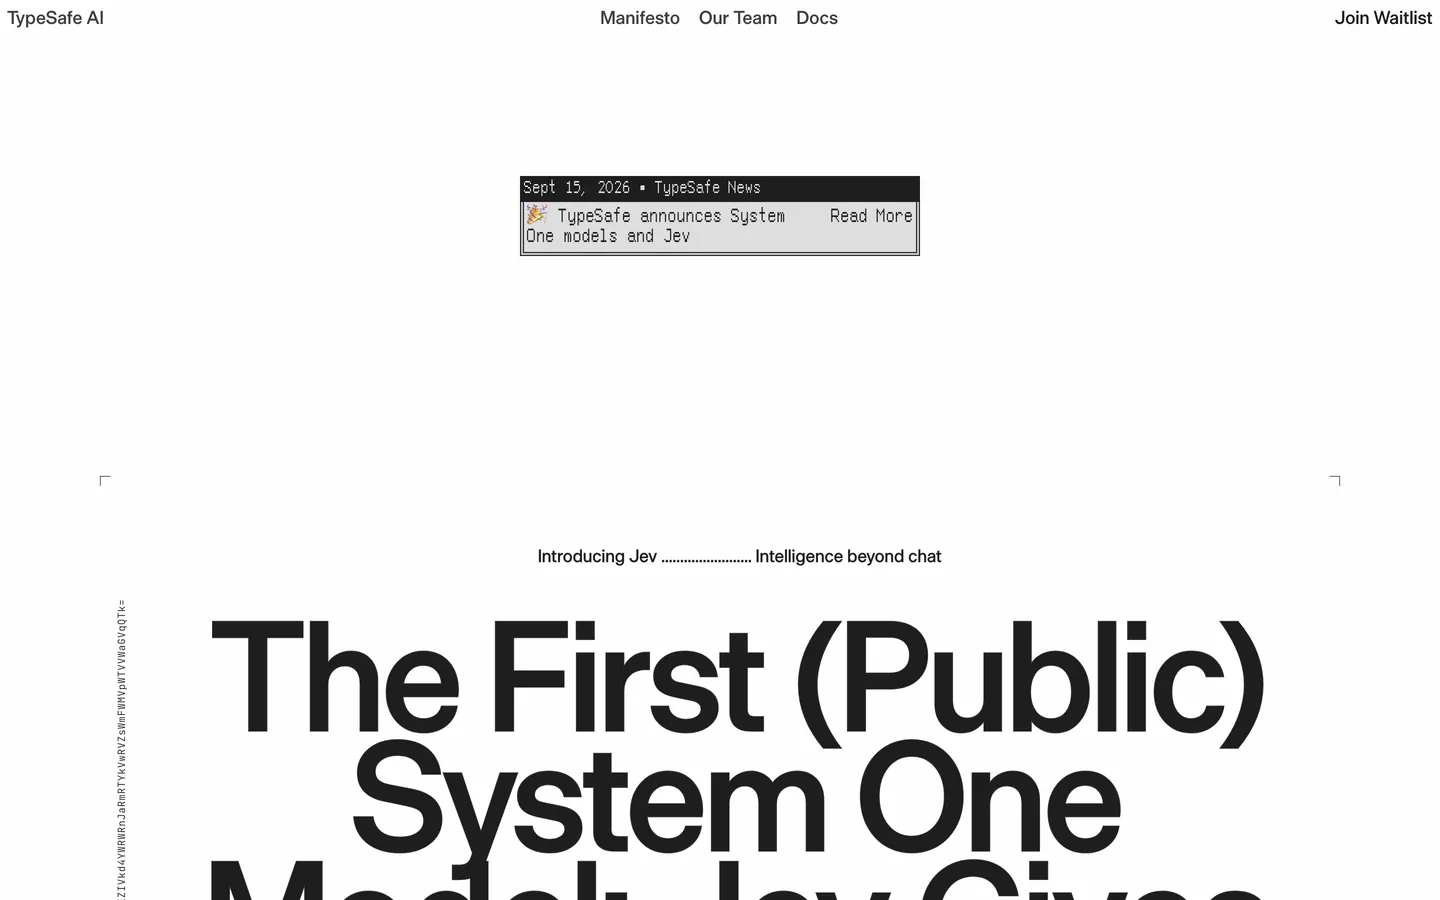
TypeSafe AI a annoncé Jev le 15 septembre 2026 comme premier « System One model » : un modèle qui renvoie des décisions typées et des probabilités calibrées, entraîné par une méthode que l'éditeur nomme RLCD (Reinforcement Learning for Calibrated Decisions), plutôt que du texte généré token par token. Sur son propre cas de démonstration, l'éditeur rapporte 0,114 seconde et 0,000081 $ pour Jev, contre 8,566 secondes et 0,013880 $ pour GPT-5.6 Terra sur la même tâche ; sa page d'accueil résume l'écart en « 193.6x Faster, 444.6x Cheaper ». La couverture presse a suivi dès le lendemain : The Register a titré sur un modèle qui « joue à Doom » avant de préciser que l'usage visé reste le tri de tickets de service client, et ActuIA a publié le 18 septembre 2026 une lecture plus mesurée, chiffres à l'appui. La levée de fonds d'amorçage de 40 millions de dollars qui finance ce lancement est rapportée à la fois par The Register et par ActuIA : elle situe l'enjeu commercial de cette annonce, distinct de sa validité technique.
Ces chiffres viennent tous du même camp : l'éditeur écrit ses propres scénarios de test et compare Jev à la moyenne de deux autres modèles, pas à une vérité terrain indépendante. MarkTechPost, qui a repris ce cas le 19 septembre 2026, le signale explicitement : « the main benchmarks are vendor-run, test on your own data ». C'est le fil que suit la suite de ce dossier : élargir aux sources qui ne sont pas TypeSafe.
| 01Source | 02Tâche mesurée | 03Latence Jev relevée | 04Date du relevé |
|---|---|---|---|
| 01askjev.ai, démo publique (172 appels) | 6 questions typées par message | 188 ms médiane, 395 ms au 95e centile | 18 et 19 septembre 2026 |
| 02TypeSafe AI, cas de démonstration éditeur | 3 questions typées, ticket support | 0,114 seconde | 15 septembre 2026 |
| 03Every, test indépendant cité par ActuIA | 777 jugements d'extraction | 0,35 s médiane (0,7 s pour l'ensemble) | 17 et 18 septembre 2026 |
| 04DevelopersIO (Classmethod), test indépendant | Classification de conversations à 4 niveaux, 40 appels | 0,643 à 0,674 s médiane | Septembre 2026 |
askjev.ai, démo publique (172 appels)
TypeSafe AI, cas de démonstration éditeur
Every, test indépendant cité par ActuIA
DevelopersIO (Classmethod), test indépendant
Le montage tient en une phrase : un Worker Cloudflare déclare un binding AI, appelle typesafe/jev avec un état et des questions typées, puis chronomètre chaque réponse. Ce n'est pas un intermédiaire comme askjev.ai ou l'API REST directe : l'appel part du même réseau qui exécute le Worker, sans serveur applicatif entre les deux. Le schéma ci-dessous résume la boucle de mesure codée pour ce banc d'essai. Aucun des bancs d'essai tiers cités plus haut ne précise s'il appelle Jev depuis un Worker natif ou par l'API REST directe : c'est précisément la variable que ce protocole isole, avant le détail des étapes pour le reproduire.
Étape 1
Dans un projet Wrangler, ajoutez la section [ai] avec binding = "AI" au fichier de configuration, comme le montre la fiche modèle Cloudflare.
Étape 2
Choisissez des messages représentatifs de votre activité, en français si c'est votre usage réel : la documentation Cloudflare ne montre que des exemples en anglais.
Étape 3
Encadrez l'appel d'un Date.now() avant et après, et conservez chaque durée dans un tableau plutôt qu'une seule moyenne.
Étape 4
Une dizaine d'appels par cas suffit pour lire une distribution plutôt qu'un seul chiffre, sensible au premier appel à froid.
Étape 5
Le tarif de typesafe/jev n'est pas public, et il ne se lit pas au même endroit que les autres modèles : provisionnez des crédits AI Gateway avant l'appel, l'allocation gratuite Neurons de Workers AI ne le couvre pas.
Le code ci-dessous est celui que La Refonte a déployé sur son propre compte Cloudflare, sur le plan gratuit de Workers AI. Il reprend le binding présenté par la fiche modèle, boucle sur six messages en français représentatifs d'un service client, chronomètre chaque appel à env.AI.run et calcule médiane et 95e centile sur les passes réalisées. La fenêtre de contexte reste limitée à 32 000 tokens selon la fiche modèle Cloudflare : un historique long doit être résumé avant l'appel. Workers AI offre 10 000 Neurons gratuits par jour ; au-delà, le plan payant facture 0,011 $ par 1 000 Neurons. Mais typesafe/jev n'y est pas rattaché : le premier appel réel de La Refonte, le 20 septembre 2026, a révélé que ce modèle route par la facturation unifiée AI Gateway, à crédits prépayés majorés de 5 %, hors de l'allocation gratuite Neurons. Copiez ce code dans un projet Wrangler, changez les messages et les critères pour vos propres cas, puis lisez le résultat en JSON à l'URL de votre Worker.
// Banc d'essai Jev depuis un Worker Cloudflare : mêmes messages et
// mêmes questions typées que pour un appel direct à l'API, mais l'appel
// part du binding AI (env.AI.run), donc la latence "depuis notre propre Worker".
const questions = {
  service: {
    type: 'choice',
    instructions: 'Quel service doit traiter cette demande ?',
    criteria: {
      livraison: 'Suivi, retard ou perte de colis',
      facturation: 'Paiement, facture, remboursement, double prélèvement',
      commercial: 'Devis, tarifs, disponibilité, nouvelle commande',
      technique: 'Produit défectueux, panne, mode d\u2019emploi',
    },
  },
  urgent: {
    type: 'noul',
    instructions: 'Le message exprime-t-il une urgence ?',
    criteria: { true: 'Urgence explicite, délai dépassé ou blocage', false: 'Aucune urgence exprimée' },
  },
  ton: {
    type: 'score',
    instructions: 'Quel est le niveau d\u2019agacement du client ?',
    criteria: ['Calme', 'Agacé', 'Très en colère'],
  },
}

const cases = [
  { id: 'colis-retard', state: 'Bonjour, je n\u2019ai toujours pas reçu ma commande passée il y a 10 jours, c\u2019est urgent.' },
  { id: 'double-prelevement', state: 'Bonjour, j\u2019ai été prélevé deux fois pour la même commande. Merci de me rembourser.' },
  { id: 'devis', state: 'Bonjour, pouvez-vous m\u2019envoyer un devis pour 20 unités ? Pas pressé, c\u2019est pour le mois prochain.' },
]

const pct = (arr, p) => {
  const s = [...arr].sort((a, b) => a - b)
  return s[Math.min(s.length - 1, Math.floor((p / 100) * s.length))]
}

export default {
  async fetch(request, env) {
    const runs = 5
    const allMs = []
    const out = { model: null, cases: [] }
    for (const c of cases) {
      const samples = []
      for (let i = 0; i < runs; i++) {
        const t0 = Date.now()
        const result = await env.AI.run('typesafe/jev', { state: c.state, questions })
        const ms = Date.now() - t0
        out.model ??= result.model ?? null
        samples.push({ ms, answers: result.answers })
        allMs.push(ms)
      }
      out.cases.push({ id: c.id, latence_ms: samples.map(s => s.ms), reponse: samples[0].answers })
    }
    out.latency_ms = { n: allMs.length, min: Math.min(...allMs), p50: pct(allMs, 50), p95: pct(allMs, 95), max: Math.max(...allMs) }
    return new Response(JSON.stringify(out, null, 2), { headers: { 'content-type': 'application/json; charset=utf-8' } })
  },
}La question qui compte pour une équipe technique n'est pas la vitesse de Jev dans l'absolu, mais l'écart avec ce qu'elle utilise déjà : un modèle de langage à qui l'on demande de répondre en JSON. Plusieurs bancs d'essai tiers, indépendants de TypeSafe, posent exactement cette question sur des tâches de classification ou d'extraction comparables.
Chez Developers Digest, le 16 septembre 2026, neuf modèles sont comparés sur un même jeu de cas : Jev répond en 0,4 seconde pour 0,0001 $ par appel avec 76,0 % de précision, contre 14,5 à 241,3 secondes et 0,0025 à 0,4856 $ pour les modèles de langage testés, à précision comparable ou légèrement supérieure. Chez DevelopersIO, un test indépendant de routage de conversations à quatre niveaux donne une médiane de 0,643 à 0,674 seconde pour Jev, contre 2,1 secondes pour Gemini 3.5 Flash et 7,2 secondes pour DeepSeek V4 Flash, sur 40 appels répartis en quatre lots de dix ; le coût y est rapporté dans deux unités différentes selon le fournisseur, par appel pour Jev (0,000025 à 0,000027 $) et par session pour Gemini (environ 0,70 $) ou DeepSeek (environ 0,0004 $), sans conversion en un chiffre commun, y compris dans ce dossier. Chez Every, cité par ActuIA le 18 septembre 2026, un test d'extraction chronomètre Jev à 0,35 seconde contre 8,83 secondes pour Claude Fable 5.1, pour une détection de 6 défauts sur 7 contre 7 sur 7 côté LLM : l'écart de vitesse est net, l'écart de justesse existe aussi, dans l'autre sens.
Source : Developers Digest, 16 septembre 2026 (benchmark décisionnel tiers, chiffres non reproduits par La Refonte)
| 01Modèle | 02Précision | 03Coût par appel | 04Latence |
|---|---|---|---|
| 01Jev (TypeSafe AI) | 76,0 % | 0,0001 $ | 0,4 s |
| 02GPT-5.6 Luna | 76,1 % | 0,0025 $ | 14,5 s |
| 03DeepSeek V4 Flash | 76,8 % | 0,0029 $ | 34,6 s |
| 04DeepSeek V4 Pro | 76,1 % | 0,0232 $ | 58,6 s |
| 05GPT-5.6 Terra | 74,7 % | 0,0778 $ | 17,3 s |
| 06GPT-6 Sol | 79,1 % | 0,2152 $ | 34,3 s |
| 07Claude Opus 5 | 78,4 % | 0,4856 $ | 92,1 s |
| 08Claude Sonnet 5 | 72,9 % | 0,3616 $ | 241,3 s |
| 09Claude Haiku 4.5 | 58,8 % | 0,0047 $ | 3,4 s |
Jev (TypeSafe AI)
GPT-5.6 Luna
DeepSeek V4 Flash
DeepSeek V4 Pro
GPT-5.6 Terra
GPT-6 Sol
Claude Opus 5
Claude Sonnet 5
Claude Haiku 4.5
La précision annoncée pour Jev varie selon la source : 67,8 % sur le banc à quatre workflows cité par Forkast le 17 septembre 2026, 76,0 % chez Developers Digest le 16 septembre 2026, 89,7 % sur le dépôt ouvert « system-one-benchmark », qui teste 174 tâches d'ingénierie logicielle avec un contrat à sept questions. Ces écarts s'expliquent par des tâches différentes, pas par une contradiction : un modèle de décision se juge sur la tâche qu'on lui pose, pas sur un score unique.
Deux réserves reviennent dans les lectures indépendantes. D'abord la méthode : Forkast note que les benchmarks de l'éditeur mesurent l'accord de Jev avec deux autres modèles de langage, GPT-6 Astra et Claude Fable 5.1, pas avec une vérité terrain vérifiée à la main. Ensuite la calibration par domaine : ActuIA relève, le 18 septembre 2026, l'absence de courbe de calibration publiée par secteur d'usage, et recommande de mesurer sur ses propres données avant de fixer un seuil de confiance. Le dépôt « system-one-benchmark » va dans ce sens : sur ses 174 tâches, un modèle bien plus petit que Jev, Decider-0.8B, obtient une précision statistiquement égale à la sienne, et un autre modèle du même banc affiche une meilleure calibration mesurée, avec une erreur de calibration attendue de 0,0314. Le même dépôt relève aussi que ces modèles plus légers tournent en 1,8 à 3,8 Go de mémoire, contre 21 Go pour l'alternative locale testée, Qwen System-One V2 : un repère utile si l'alternative envisagée est un modèle auto-hébergé plutôt qu'un appel API. Forkast note enfin que TypeSafe reste en accès anticipé à la date de son article, le 17 septembre 2026, sans client de production nommé ni chiffre d'affaires communiqué : l'usage en production reste à valider dans la durée, pas seulement sur un banc d'essai ponctuel. Aucun de ces chiffres ne remplace un test sur vos propres messages.
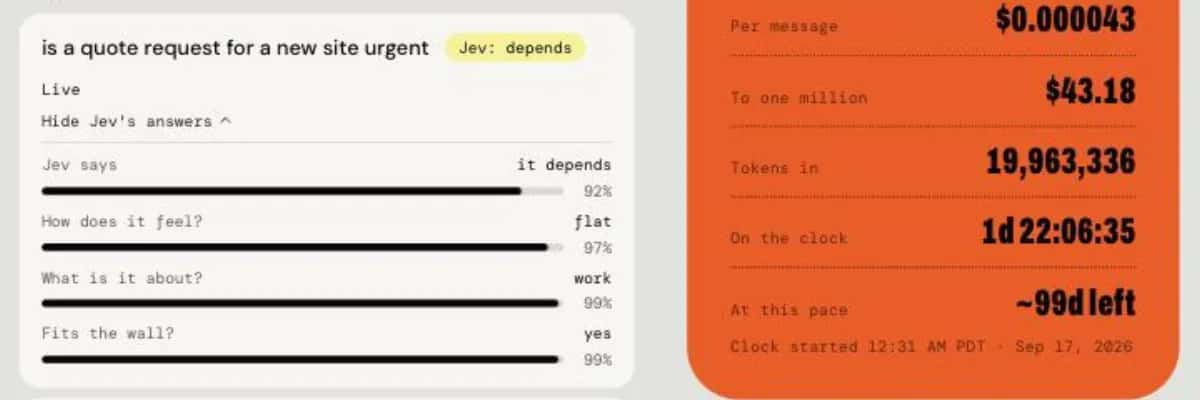
Pour une PME qui trie ses tickets ou ses formulaires entrants, ces chiffres se traduisent en deux effets concrets. Le premier est le délai perçu : une latence de l'ordre de 200 millisecondes tient dans le temps d'affichage d'une page, là où un modèle de langage de plusieurs secondes impose une file d'attente ou un traitement différé. Le second est le volume accessible : à 0,0000444 $ par appel selon la démo askjev.ai, ou 0,0001 $ selon Developers Digest, trier plusieurs milliers de messages par mois reste sous le seuil d'un abonnement logiciel classique, sans dimensionner un budget de tokens comme pour un LLM qui rédige. Sur la démo askjev.ai, 18 870 messages affichaient un coût cumulé de 0,8385 $ au 19 septembre 2026 : à cette échelle, le poste « appels au modèle » pèse moins qu'une seule heure de tri manuel, même pour un volume mensuel élevé.
Cet ordre de grandeur ne dit rien de la justesse sur vos propres messages, en français, sur votre jargon métier : c'est justement ce que la documentation ne montre pas. La lecture prudente est de traiter Jev comme un tri rapide et bon marché pour des décisions fréquentes et réversibles : router, prioriser, étiqueter, avec un seuil de confiance et une relecture humaine sous ce seuil. C'est aussi la limite du modèle : il ne rédige pas de réponse et ne remplace pas une personne sur un cas que sa propre probabilité juge ambigu.
La Refonte a exécuté le protocole décrit plus haut le 20 septembre 2026, depuis un poste connecté par Starlink, via l'API OpenRouter (endpoint /api/alpha/decisions, modèle typesafe/jev-1.13-20260917) : 6 messages-tests, soumis 5 fois chacun, soit 30 appels. La latence rapportée ici est un aller-retour client complet depuis ce poste, pas la latence serveur d'un Worker Cloudflare ni celle d'askjev.ai : les deux relevés ne se comparent pas terme à terme.
| 01Message-test | 02Service attendu | 03Service obtenu | 04Confiance | 05Urgence (0-1) | 06Ton (0-2) | 07Stable sur 5 passes |
|---|---|---|---|---|---|---|
| 01Colis en retard | Livraison | Livraison | 1,00 | 0,98 | 1,00 | Oui |
| 02Double prélèvement | Facturation | Facturation | 1,00 | 0,10 | 0,19 | Oui |
| 03Demande de devis | Commercial | Commercial | 1,00 | 0,03 | 0,00 | Oui |
| 04Panne, ton en colère | Technique | Technique | 1,00 | 0,93 | 1,99 | Oui |
| 05Facture, ton calme | Facturation | Facturation | 1,00 | 0,03 | 0,00 | Oui |
| 06Message ambigu, construit sans service évident | Aucun service évident | Technique | 0,56 | 0,20 | 0,86 | Oui (même sortie sur les 5 passes) |
Colis en retard
Double prélèvement
Demande de devis
Panne, ton en colère
Facture, ton calme
Message ambigu, construit sans service évident
| 01Centile | 02Latence mesurée (OpenRouter, poste Starlink) | 03Repère serveur askjev.ai |
|---|---|---|
| 01Minimum | 396 ms | non publié par centile |
| 02Médiane (p50) | 497 ms | 188 ms |
| 0395e centile (p95) | 773 ms | 395 ms |
| 04Maximum | 930 ms | non publié par centile |
Minimum
Médiane (p50)
95e centile (p95)
Maximum
Les 30 appels du protocole ci-dessus ont consommé 15 365 tokens en entrée et 2 480 tokens en sortie pour un coût total de 0,00065 $, soit environ 0,0000217 $ par appel. Par simple multiplication, sans autre hypothèse : 1 000 messages traités représenteraient environ 0,02 $, et 10 000 messages environ 0,22 $, hors éventuels frais de plateforme distincts du coût du modèle.
Le message construit délibérément sans service évident, en dernière ligne du tableau ci-dessus, est le plus instructif du lot : Jev y répond quand même une catégorie, technique, à 0,56 de confiance, mais avec une confiance nettement plus basse que sur les cinq autres cas, tous à 1,00, et de façon stable sur les 5 passes. C'est exactement ce qu'un seuil de confiance doit faire : ne pas empêcher le modèle de répondre, mais repérer la réponse la moins sûre pour la renvoyer à une relecture humaine plutôt que de l'appliquer automatiquement. Le fondement statistique du seuil, kappa de Cohen compris, est détaillé dans notre jeu d'essai en français, qui applique le même principe à 30 messages annotés.
Dernière mise à jour : 20 septembre 2026
Le code du Worker de mesure est publié dans cet article, sans inscription : copiez-le, changez les questions et lisez vos propres chiffres avant de dimensionner un projet. La Refonte accompagne les équipes qui veulent cadrer une décision IA avec un seuil, un journal et une relecture humaine.
Pour aller plus loin

Sans engagement, sans jargon
Trente minutes pour identifier ce qui freine votre visibilité et repartir avec les priorités dans le bon ordre.
Discutons de votre projet
30 min · Google Meet
Choisissez le créneau qui vous convient dans notre calendrier. On analyse votre situation avant l’appel pour aller droit au but.
Recherche des créneaux disponibles...